* 해당 논문 리뷰는 글쓴이가 직접 읽고 이해한 내용을 바탕으로 작성된 것이므로 잘못된 정보가 포함될 수 있습니다. 잘못된 정보는 댓글로 남겨주시면 반영하겠습니다 : )
Introduction
이 논문은 암상별 퇴적 구조의 희소 표현을 중합 전 탄성파 역산에 결합합니다. 서론의 암상 제어 확률론적 역산과 가우스 혼합 모델은 선행연구이며, 본 논문의 세 가지 제안 기법으로 묶으면 기여를 잘못 이해하게 됩니다. 핵심은 암상을 나누고 각 암상의 검층 자료에서 구조를 추출해, 역산 결과를 해당 암상의 구조로 표현하며 반복하는 것입니다.
Theory
Inversion framework
inversion framework는 다음 (1)식과 같으며, 이를 간단히 표현하면 식 (2)와 같이 표현된다.
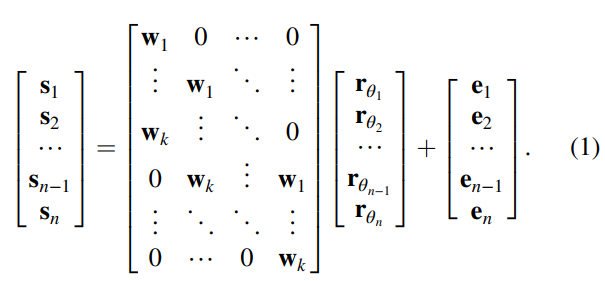
그림 설명: 식 1. 입사각별 탄성파 자료를 웨이블릿, 반사계수와 잡음으로 표현하는 전방 모델.
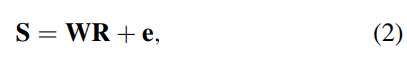
그림 설명: 식 2. 전방 모델의 행렬 표기 S=WR+e. S는 관측 자료, W는 웨이블릿 행렬, R은 반사계수, e는 잡음이다.
여기서 S는 관측된 seismic data를 나타내는 벡터이고, W는 seismic wavelet matrix, R은 반사 계수 행렬로, 저류층 탄성 속성(P파 속도, S파 속도, 밀도 등)에 따라 결정된다. e는 노이즈 벡터이다.
다음으로, 탄성 매개변수 Vp, Vs, ρ를 모델 매개변수 m으로 변환하는 과정을 정의하며, 이 변환은 inversion을 수행하기 전에 매개변수 공간을 재정의하여 inversion 과정을 용이하게 한다. 해당 과정은 식 (3)과 같다.
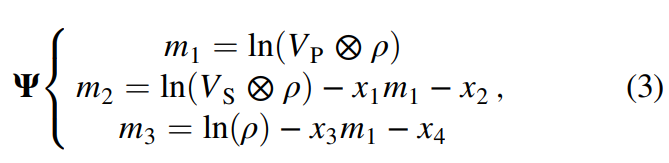
그림 설명: 식 3. Vp·Vs·밀도를 역산 모델 매개변수로 바꾸는 변환. 원 안의 곱 기호는 원소별 곱이다.
ⓧ는 원소별 곱(element-wise multiplication)을 나타냅니다. 합성곱이나 크로네커 곱이 아닙니다. x1~x4는 탄성 매개변수 변환에 쓰이는 계수입니다.
위 식(3)에 나타낸 선형 변환 수식을 다시 원래의 탄성 매개변수로의 역변환으로 정의한다. 이를 통해 inversion 과정에서 얻은 모델 매개변수를 실제 저류층의 물리적 특성으로 해석할 수 있다. 이는 식 (4)와 같이 나타낸다.
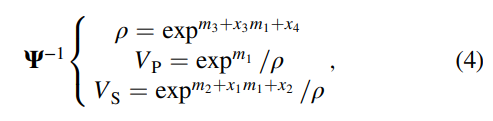
그림 설명: 식 4. 역산 모델 매개변수에서 원래 탄성 매개변수로 돌아가는 역변환.
Φ는 difference matirx이며, 반사계수 행렬 R은 R = Φm으로 나타낼 수 있다. 이를 통해 식(5)과 같은 inversion 수식을 얻을 수 있다.
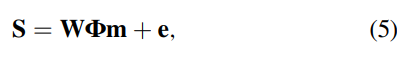
그림 설명: 식 5. 반사계수 R=Φm을 전방 모델에 대입한 탄성파 자료와 모델 매개변수의 관계.
위 식 (5)에서 관측된 seismic data S와 모델 매개변수 m과 선형 관계를 가지므로, G = WΦ 로 정의하면 식(6)과 같이 표현할 수 있다.
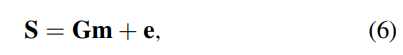
그림 설명: 식 6. G=WΦ로 정의한 선형 전방 관계 S=Gm+e.
이 수식들은 관측된 seismic data S와 모델 매개변수 m 사이의 관계를 설정한다.
inversion 과정에서 이 관계를 최적화하는 것이 목표이다.
마지막으로, 식 (7)과 같이 최적화 공식을 정의한다.
일반적으로 inversion framework는 두가지 항으로 구성된다. 첫 번째 항은 데이터 정합성 항으로, framework의 핵심이며, inversion 결과가 관측된 데이터와 일치하도록 보장한다. 두 번째 항은 제약조건으로, 이는 inversion 결과가 선행 정보와 일치하도록 보장한다.
데이터 적합 항은 관측 탄성파 S와 모델 m에서 계산한 예측 탄성파 Gm의 차이를 줄입니다. 서로 다른 물리량인 S와 m을 직접 빼는 것이 아닙니다. 제약 항은 사전정보를 반영하지만, 잡음과 모델 오차가 있는 역문제에서 해의 정확성이나 유일성을 보장하지는 않습니다.
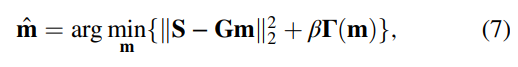
그림 설명: 식 7. 관측 자료와 예측 자료의 차이를 줄이는 데이터 적합 항에 가중치 β를 곱한 제약 항 Γ(m)를 더한 역산 목적함수.
β는 데이터 정합성 항과 제약 항 사이의 균형을 조절하는 가중치이고, Γ(m)는 제약 항(주로 암상 정보와 같은 사전 정보에 기반)이다.
Collaborative sparse representation
탄성 매개변수의 구조적 특성을 지하 암석에서 나타내기 위해 다양한 시나리오에 적응할 수 있는 SR (sparse representation) 알고리즘을 선택한다.
seismic data는 선형조합을 사용하여 희소하게 표현될 수 있으며, 이 과정에서 사전(dictionary)에 정의된 원자(atoms)들을 사용하여 데이터를 재구성한다.
K-SVD (K-Singular Value Decomposition)는 희소 표현을 위한 사전을 학습하는 기술이다. 이 방법은 각 샘플을 최소한의 원자로 효과적으로 표현하여 데이터의 중요한 특징을 추출한다.
최적화 문제는 식(8)과 같이 표현할 수 있다.
Yp, Ys, Yρ의 훈련 자료를 각각 Dp, Ds, Dρ 사전으로 표현합니다.
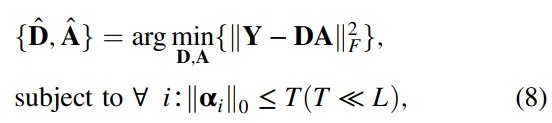
그림 설명: 식 8. 훈련 표본 행렬 Y를 사전 D와 희소 계수 A의 곱으로 근사하는 사전 학습 문제.
- Y는 훈련 샘플 행렬이며 M은 샘플 길이, N은 샘플 수입니다. 여기서 Yp·Ys·Yρ는 정규화된 탄성 매개변수 훈련 자료를 뜻합니다. 관측 탄성파 자료 S와 구분해야 합니다.
- D (사전): 원자(atom)들의 집합으로 구성된 R^M x L 차원의 행렬이다. 여기서 L은 사전에 있는 원자의 수로, 데이터를 표현하는 데 사용되는 기본 요소들이다.
- A (계수 행렬): 각 데이터 샘플 를 사전 의 원자들의 선형 조합으로 표현할 때 사용되는 계수들의 집합이다. 이는 RL x N 차원의 행렬.
- 프로베니우스 노름 (∥⋅∥𝐹): 행렬의 원소 전체의 제곱 합의 제곱근으로, 행렬 간의 차이(오류)를 측정한다.
CSR은 탄성 매개변수 간의 상관관계에 기초한 동시 알고리즘이다.
다양한 탄성매개변수에 대해 개별적으로 최적화된 사전을 학습하여 각 매개변수의 특성을 잘 반영하도록 한다.
CSR을 사용함으로써 각 탄성매개변수의 독립적인 특징을 반영하는 맞춤형 사전을 구축할 수 있으며, 이를 통해 seismic inversion의 정확도를 향상시킬 수 있다.
CSR의 최적화 문제는 식(8)을 이용하여 식(9)와 같이 나타낼 수 있다.
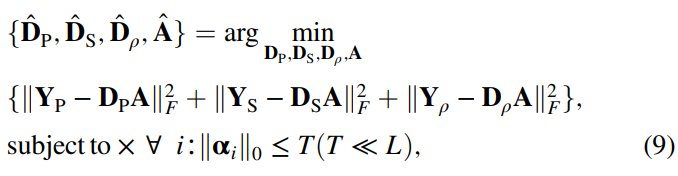
그림 설명: 식 9–10. Vp·Vs·밀도의 정규화 훈련 표본에 대해 사전과 희소 계수를 함께 구하는 collaborative sparse representation.
여기서 Yp, Ys, Yρ는 각 탄성 매개변수에 대한 표준화된 훈련 데이터 세트를 나타낸다. Dp, Ds, Dρ는 각 탄성 매개변수에 대한 사전을 나타낸다.
CSR 알고리즘은 탄성 매개변수의 기본 구조와 구조적 관계를 추출할 수 있다. 실제 처리에서 추출 과정은 다섯 단계로 나눌 수 있다.
- well log는 중복 부분을 제거하고 목표 수평의 데이터 세그먼트만 유지하여 교정되며, 다른 저류층의 퇴적 특성이 목표 저류층과 혼합되어 inversion 과정에 영향을 미치지 않도록 한다.
- 다른 탄성 매개변수 간의 스케일 영향을 제거하기 위해 well log를 정규화한다.
- 목표층의 보존된 well log는 원소의 길이에 해당하는 작은 블록으로 차단되어 나뉜다.
- CSR 알고리즘을 사용하여 훈련 샘플에서 사전을 학습한다. 사전의 원자적 특성은 저류층 매개변수의 구조적 특성을 나타낼 수 있다.
- 사전의 원자들은 정규화된다. 이는 사전의 원자 d가 저류층 매개변수의 구조적 정보만을 포함하는 반면, 값 범위 정보는 희소 계수 a에서 반영된다.
이 과정은 각 사전을 동시에 학습하면서 각 매개변수 간의 관계를 포착하고, 이를 통해 보다 정확한 inversion 결과를 도출할 수 있다.
Facies-controlled inversion via CSR
퇴적특성(퇴적 층리, 구조, 암석학)은 seismic 암상 분석을 통해 식별 가능하다.
암상의 정확성이 inversion 결과의 정확성에 직접적인 영향을 미친다.
딥 속성은 ANN을 사용하여 seismic data에서 추출된 seismic 속성이다.
seismic data의 딥 속성은 다른 seismic 파형 데이터 및 seismic 속성보다 seismic 측면 특성의 세부 정보를 더 많이 제공할 수 있다.
seismic data의 유효 정보는 오토 인코더를 사용하여 seismic 파형에서 딥 속성을 추출하고 동시에 여러 속성을 결합하여 seismic 속성 퓨전을 수행할 수 있다.
다중 작업 학습은 여러 학습 작업이 동시에 수행될 때 네트워크의 일반화를 향상시킨다.
seismic 파형과 seismic 속성을 훈련 데이터로 사용함으로써 seismic 파형과 seismic 속성이 모두 딥 속성에 제약을 가하거나 기여한다.
딥 속성을 seismic 암상으로 클러스터링 하는 과정에서 가장 일반적인 SOM seismic 파형 클러스터링 알고리즘이 사용된다.
CSR 알고리즘을 사용하여 inversion 프레임워크에서 다양한 암상을 대표한다. 이때, 각 암상의 모델 매개변수 m이 사전 D의 일부 원자에 의해 선형적으로 결합될 수 있다고 가정한다. 그런 다음, 최적화 문제에 대한 제약조건은 식(11)과 같이 나타낼 수 있다.
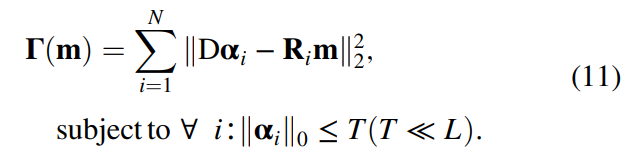
그림 설명: 식 11. 모델에서 추출한 패치 Ri m을 사전 원자와 희소 계수 Dαi의 조합으로 근사하는 제약.
- D: 사전 행렬로, 데이터를 가장 잘 나타내는 원자들의 집합.
- αi: 각 패치에 대한 희소계수 벡터로, 사전 원자들의 선형조합을 통해 데이터 패치를 표현한다.
- Ri: 각 i번째 패치에 해당하는 데이터 부분을 추출하는 행렬로, m에서 해당 패치에 해당하는 부분만을 선택한다.
- m: 모델 매개변수 벡터로, 전체 데이터를 표현하는 데 사용된다.
위 식(11)에 나타낸 최적화 과정은 데이터 Dαi와 실제 데이터 패치 Rim 간의 차이를 최소화하려고 한다.
식(11)과 식(7)을 결합하여 본 논문에서 π를 사용하여 다양한 암상을 나타내고, 새로운 암상 제어 inversion을 통한 CSR(FCSR)은 다음 식(12)을 통해 설명될 수 있다.
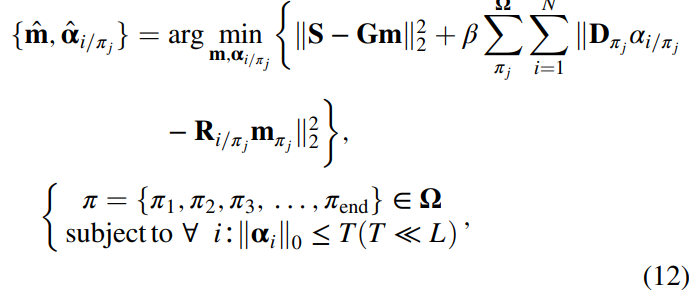
그림 설명: 식 12. 관측 적합 항과 암상별 희소 표현 제약을 결합한 FCSR 역산 목적함수.
- S: 관찰된 seismic data.
- G: 웨이블릿과 반사 계수의 합성으로 이루어진 커널 행렬.
- πi: 각기 다른 암상을 나타내는 인덱스.
- Ω: 모든 가능한 암상의 집합.
- β: 데이터 정합성 항과 암상 제약 항 사이의 균형을 맞추는 데 사용되는 가중치.
위 식(12)를 통해 seismic data와 모델 m을 통한 예측 간의 차이를 최소화하면서, 동시에 각 암상에 대한 구조적 특성이 사전 정보와 일치하도록 하는 데 초점을 맞춘다.
식(12)의 최적화 과정을 수행하는 단계는 다음 식(13), (14)와 같다.
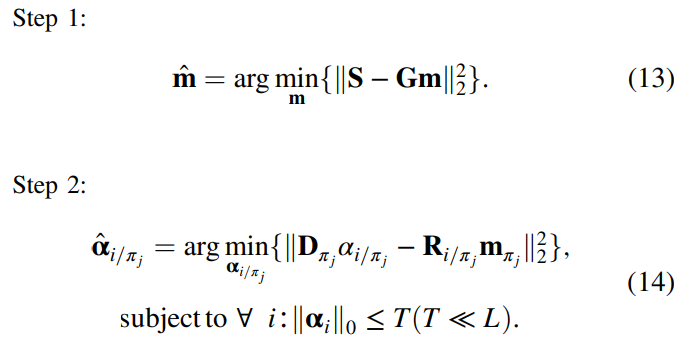
그림 설명: 식 13–14. 모델 추정과 암상별 희소 계수 추정을 번갈아 수행하는 두 최적화 단계.
Step 1에서 m^은 초기 모델 매개변수 추정치이며, Step 2는 각 암상에 대해 최적의 희소 계수를 찾는 단계이다.
이 과정은 각 암상에 대한 구조적 특성을 추출하고, 이를 통해 보다 정확한 inversion 결과를 얻기 위해 반복적으로 수행된다. 각 반복은 seismic data와 일치하는 저류층 매개변수를 추정하는 데 도움을 주며, 암상 정보를 사용하여 보다 정밀한 결과를 도출하는 데 중요한 역할을 한다.
fig. 1은 본 논문에서 제안하고 있는 inversion 방법의 프레임워크를 보여주고, 구체적인 알고리즘은 algorithm 1에서 자세히 설명하고 있다.
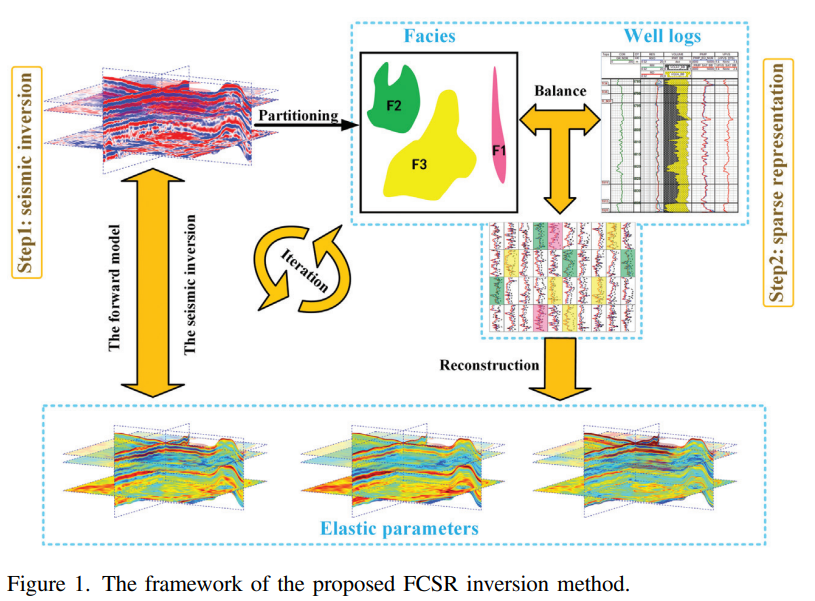
그림 설명: 그림 1. 암상 분류, 암상별 훈련 자료와 사전 구성, 희소 표현을 이용한 역산을 연결한 FCSR 처리 흐름.
- Step 1: seismic data를 사용하여 암상 분리.
- Step 2: 암상을 균형 있게 조정하고, well log data를 기반으로 각 암상의 특성을 조정한다.
- Step 3: 암상에 따라 데이터를 재구성하고, 각 암상에 맞는 탄성 매개변수를 추출하여 최종적으로 저류층의 탄성 매개변수를 시각적으로 표현.
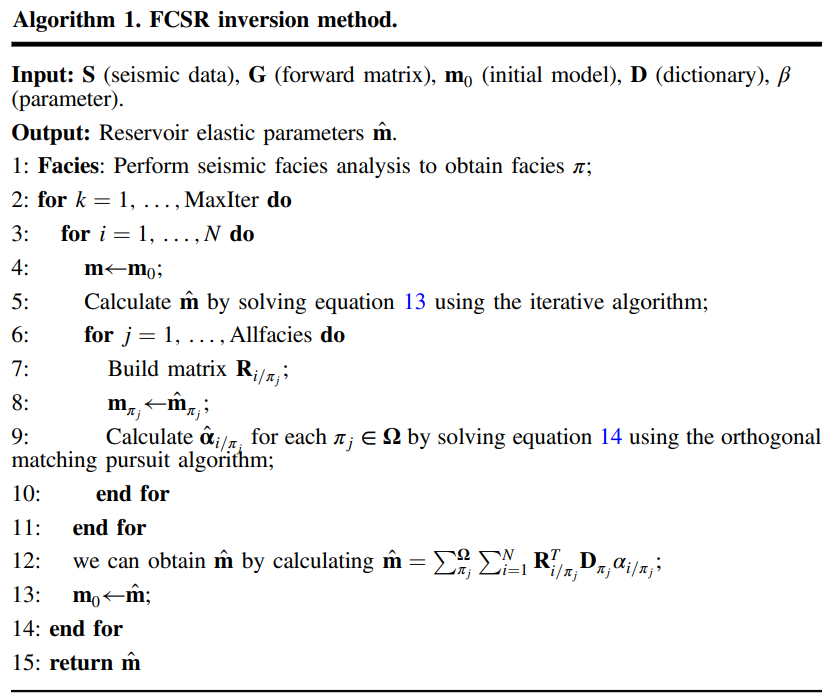
그림 설명: 알고리즘 1. 암상별 사전을 사용해 모델과 희소 계수를 반복 갱신하는 FCSR 절차.
- seismic 암상 분석을 수행: 암상 π를 얻기 위해 seismic data로부터 암상 분석을 수행
- 최대 반복 수만큼 반복 실행
- mk를 초기 모델 m0로 설정.
- 모든 암상에 대해 다음을 수행
- m^ 계산: 반복 알고리즘(식 13)을 사용하여 m^을 계산
- Ri,j 행렬 구축: 각 암상과 샘플에 대한 Ri,j 행렬을 구축
- αi 계산: 각 샘플 j에 대해 식 (14)를 사용하여 αi를 계산.
- mk에서 m^을 빼서 새로운 mk를 업데이트한다.
- mk를 초기 모델 m0로 설정.
- m 계산: 각 암상과 샘플에 대해 m^을 계산하여 m을 얻는다.
- 최종 m 반환: m0에서 최종 mk를 빼서 최종결과 m^을 얻고 반환한다.
Synthetic Data Test
The SR of facies in WSM
fig. 2에 나타난 것과 같이, 가장 간단하지만 설득력 있는 WSM (Wedge-Shaped Model)을 크기 80*1000으로 사용하여 inversion 방법을 검증한다. 상부와 하부는 mudstone으로 구성되며, 중간에는 sandstone이 존재한다. 상부 mudstone의 P파 속도는 3000 m/s, 중간 sandstone의 P파 속도는 4800 m/s, 하부 mudstone의 P파 속도는 4000 m/s이다. 각 매체의 S파 속도와 밀도는 경험적 공식을 통해 계산된다.
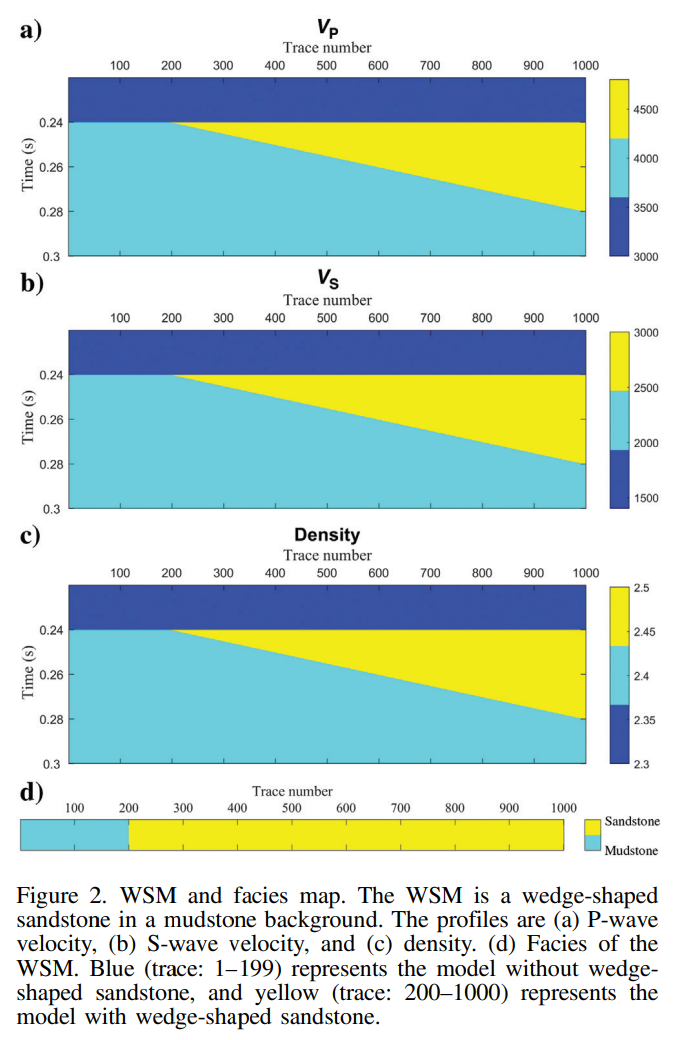
그림 설명: 그림 2. 이암 사이에 쐐기형 사암을 둔 WSM 합성모델과 암상 구분.
암상별로 seismic 암상을 나눈 후 각 암상에서 훈련 well의 균형이 맞지 않는 문제가 발생할 수 있다. 일부 암상에서 사전을 위해 사용된 훈련 well 수가 현저히 적다. 지나치게 적은 훈련 well은 추출된 구조적 특성의 불완전성을 초래하며, 이는 전체 암상의 퇴적 패턴을 대표하기에 충분하지 않다.
fig 3a와 b에서 보듯, 10 m 미만 두께의 sandstone 샘플과, 40 m 이상 두께의 샘플 수가 다른 범주보다 현저히 낮다. 이 두 암상에서 학습된 특성의 수도 확실히 낮다. 따라서 inversion 과정 중 저류층 매개변수를 대표할 적절한 구조적 특성이 없다. 이러한 경우, 지구통계학적 보간을 통해 샘플 수를 늘린다.
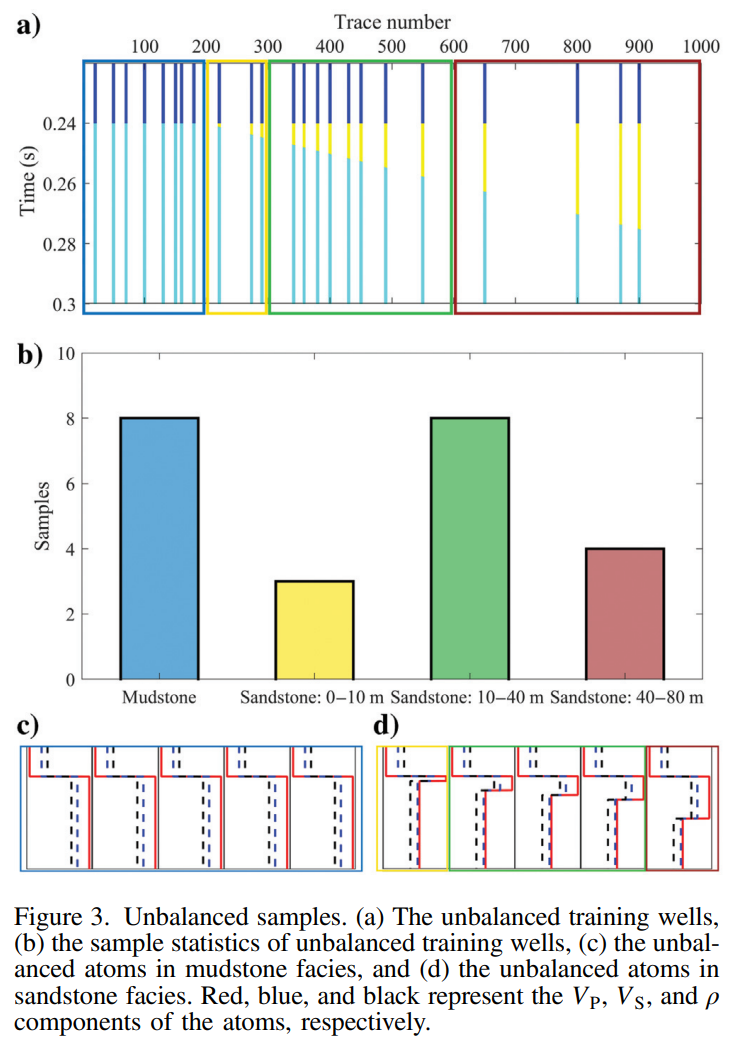
그림 설명: 그림 3. 사암 두께 범주별 훈련 표본의 불균형과 보간으로 표본을 보완하는 과정.
훈련 well의 불균형 문제를 해결한 후, 다른 암상에서 구조적 특성을 학습한다.
fig. 4에서 보듯, 암상(fig. 2d)을 제약조건으로 사용하여 다른 암상의 WSM 사전을 추출한다. Wedge형 sandstone이 없는 구조적 특성은 fig. 4c와 같다. sandstone이 없기 때문에 mudstone 암상의 특성은 모두 동일하고, 하나의 특징적인 원자만 학습되었다. 또한 sandstone 암상에서는 다양한 두께의 Wedge형 sandstone을 포함하는 구조적 특성이 학습되었다. fig. 4d에서 보듯, sandstone의 두께에 따라 원자를 배열한다. 원자의 구조는 실제 sandstone의 특성과 일치한다.
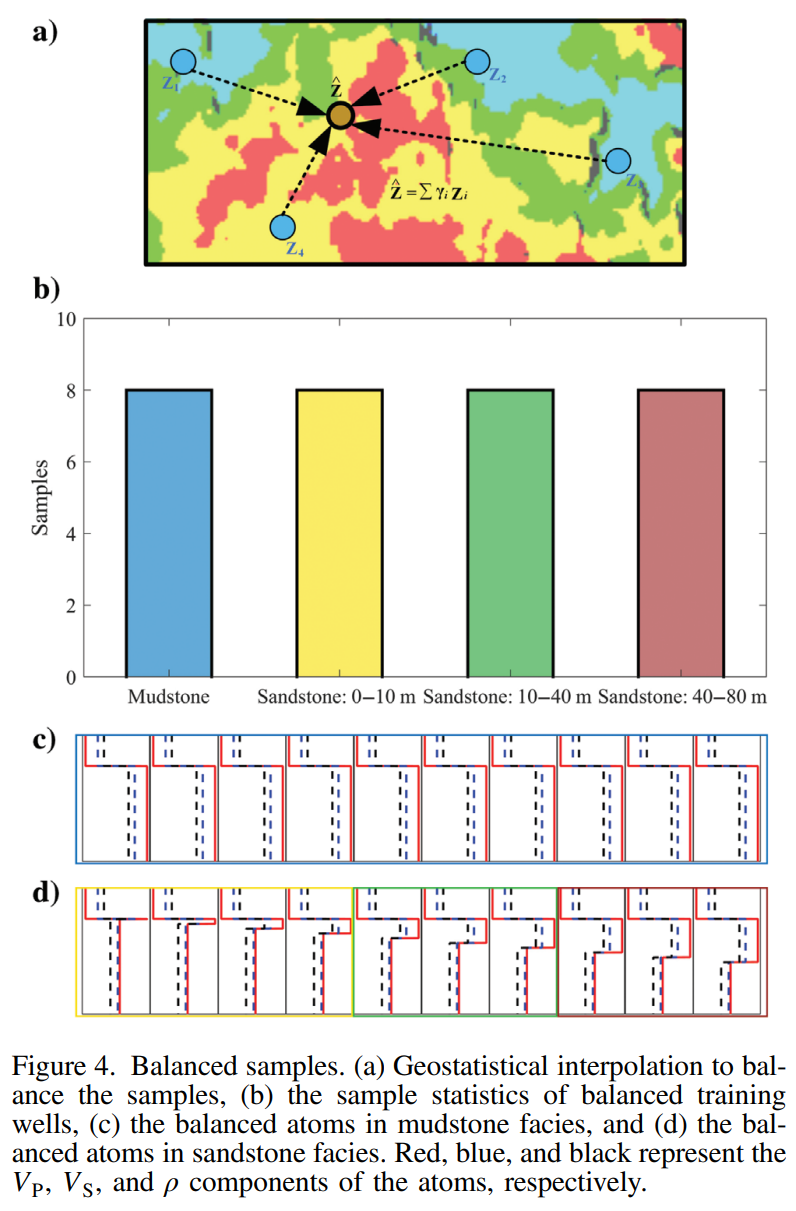
그림 설명: 그림 4. WSM에서 암상별로 학습한 사전 원자와 사암 두께에 따른 구조적 차이.
Inversion results of the WSM
합성 seismic data는 식(6)에 따라 생성된 prestack angle gather로, 45 Hz Ricker 웨이블릿을 사용한다.
fig. 5에서 보듯, angle gather에 4 dB의 잡음을 추가한다.
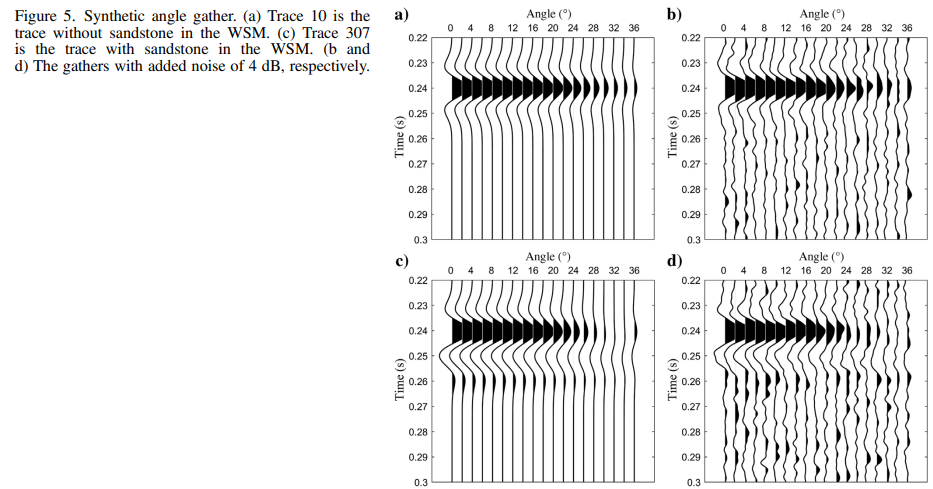
그림 설명: 그림 5. 합성 입사각 모음 자료와 잡음을 추가한 시험 자료.
본 논문에서는 WSM을 10 Hz 미만으로 필터링하여 inversion의 초기값으로 사용하고, 테스트를 진행한다.
fig. 6은 단일 트레이스 inversion에 대한 결과이다. 왼쪽은 SR에서 주로 사용되는 원자이고, 오른쪽은 탄성 매개변수 곡선이다. sandstone이 없는 경우(fig. 6a)와 두꺼운 sandstone이 있는 경우(fig. 6b)에서 제안된 방법은 해당 탄성 매개변수 곡선을 정확하게 재구성할 수 있다.
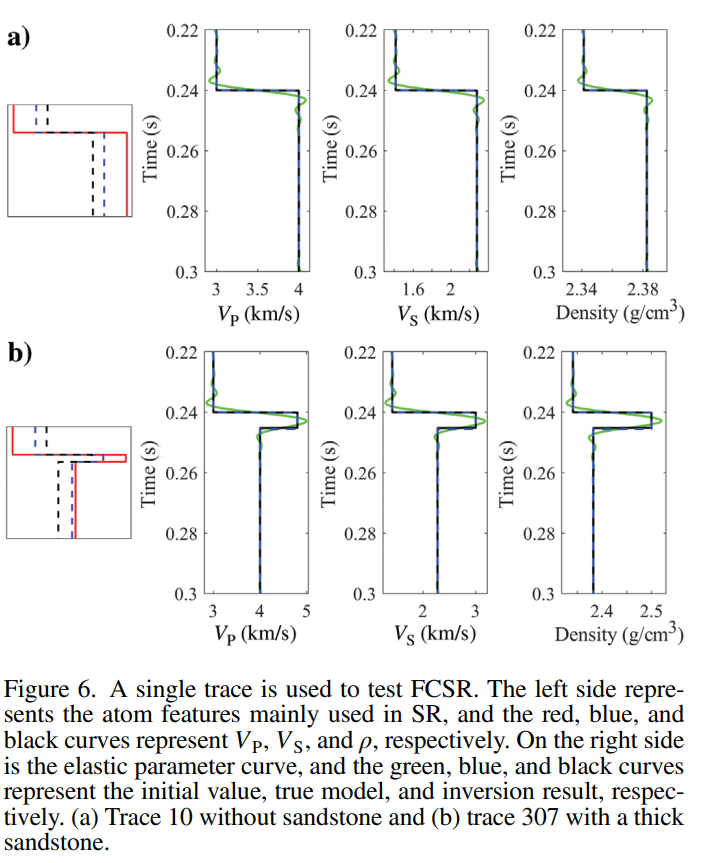
그림 설명: 그림 6. 사암이 없는 경우와 두꺼운 사암이 있는 경우의 사전 원자 및 탄성 매개변수 복원 비교.
제안된 방법은 GMMI inversion 방법, 전통적인 CSR inversion 방법, LFC inversion 방법과 비교되었다.
fig. 7에 나타낸 것과 같이, 두께가 5.5m 일 때, FCSR inversion 방법은 sandstone을 정확하게 invert 할 수 있다. sandstone의 두께가 계속 감소할 때, inversion 결과의 오류는 증가한다.
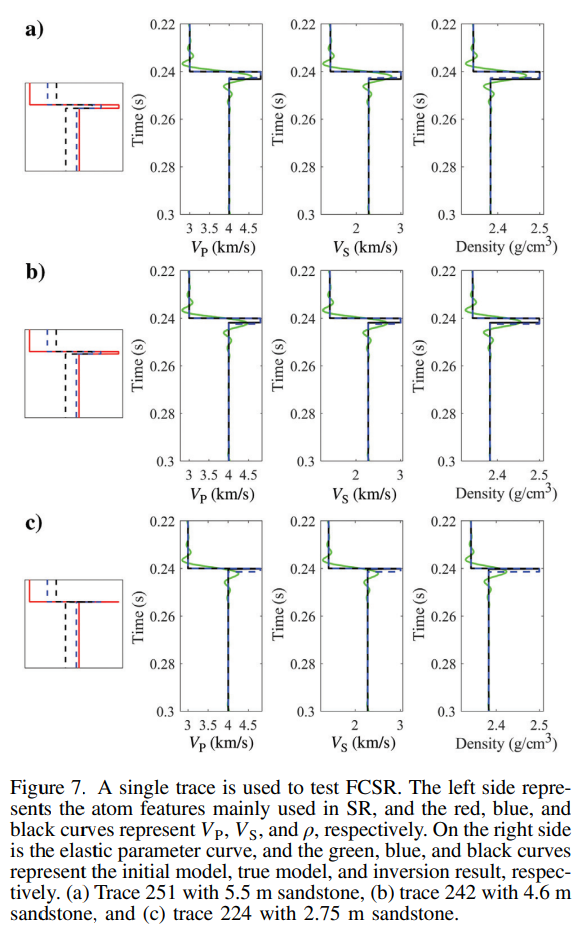
그림 설명: 그림 7. 사암 두께를 줄였을 때 여러 역산 방법의 복원 결과 비교.
다양한 두께의 sandstone에서 inversion의 오류를 계산한다. sandstone 두께가 2m일 때, 오류는 대략 30%이다. 오류가 30%를 초과하면, fig. 8과 같이 sandstone 두께가 더 부정확하게 식별된다.
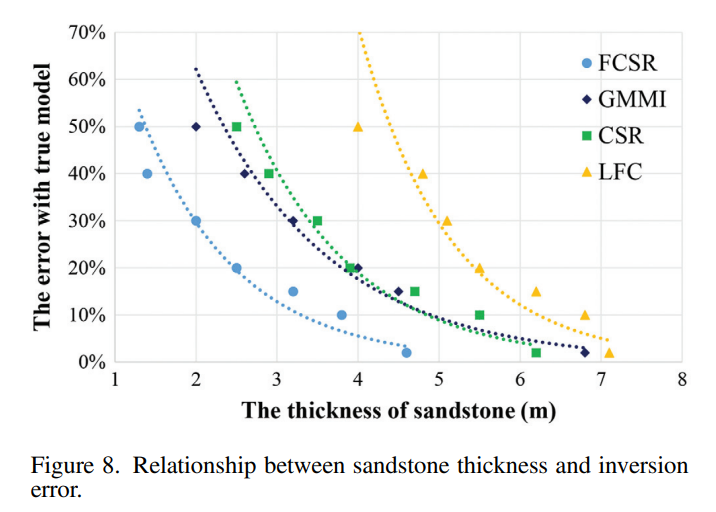
그림 설명: 그림 8. 얇은 사암의 두께와 역산 오차의 관계. 얇아질수록 오차가 커지는 실험 결과.
fig. 9에 표시된 LFC, CSR, GMMI의 inversion 결과를 비교할 때, LFC와 GMMI의 inversion 결과는 모델의 구조적 특성과 현저하게 다르다. sandstone에 대한 반응이 있긴 경계가 하지만 흐릿하다. sandstone의 두께가 클 때, CSR inversion 결과는 sandstone의 경계 특성을 정확하게 재구성할 수 있다. 하지만, sandstone의 두께가 점차 감소하면 오류가 급격하게 증가한다. FCSR이 암상 제어 inversion 방법이기 때문에 sandstone 두께가 감소할 때, invert 할 수 도 있지만, inversion 결과와 모델의 실제 두께사이에 큰 오류가 존재한다.
다양한 inversion 방법을 사용하여 invert 할 수 있는 sandstone 두께는 table. 1과 같다.
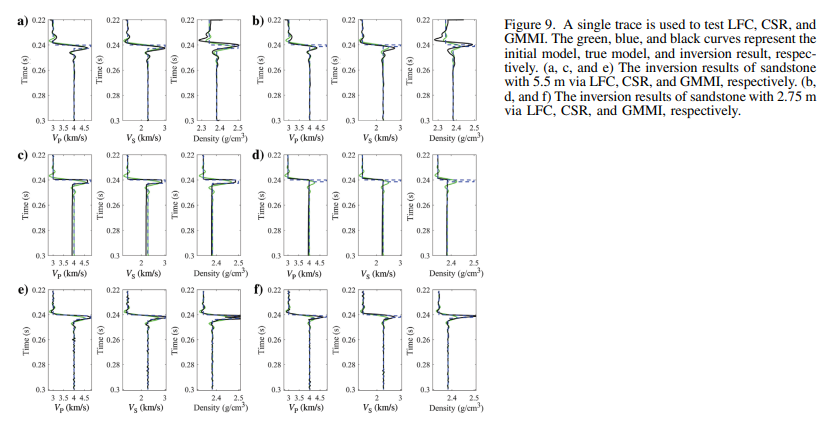
그림 설명: 그림 9. WSM에서 LFC·CSR·GMMI·FCSR의 역산 결과 비교.
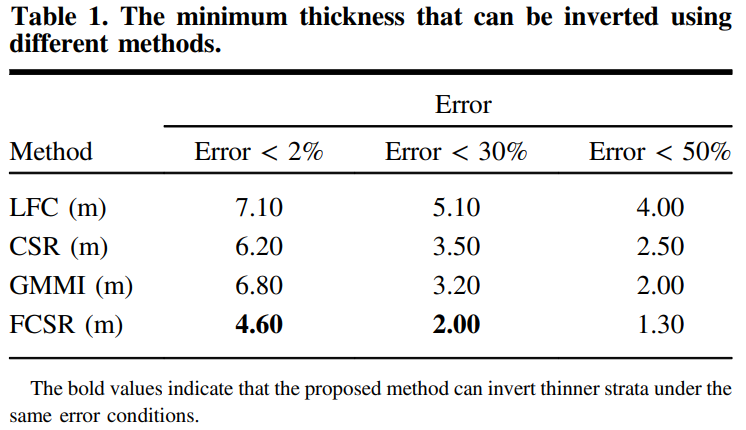
그림 설명: 표 1. 합성모델 실험에서 방법별로 식별한 사암 두께 비교.
Field Data Example
Data detail and sedimentary background
현장 데이터의 실제크기는 인라인 501, 크로스라인 631이며, 사용 가능한 well log는 66개이다.
또한 특정 지역의 대상 저류층에 대한 3D 데이터 세트로 구성된다.
fig. 10은 대상 저류층의 퇴적 고 지형도를 나타낸 것이다.
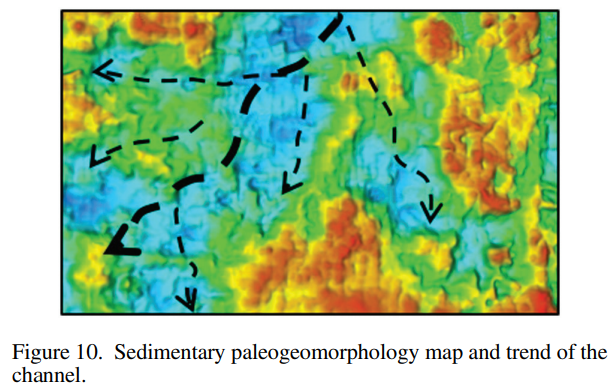
그림 설명: 그림 10. 현장 목표 저류층의 퇴적 배경과 주 채널·지류의 공간적 분포.
퇴적 배경은 호수 델타 퇴적 환경으로, 주요 채널이 북동쪽에서 남서쪽으로 발달하고 있으며, 주요 채널 양쪽에 많은 지류 채널들이 발달해 있다. 대상 저류층은 극히 얇은 sandstone으로 구성되어 있으며, 이들은 측면 연속성이 떨어지는 특성을 가진다.
fig. 11에서 보듯이, 이 sandstone의 seismic 응답은 임피던스에 대한 약한 반응을 보이지만, 낮은 P파 대비 S파 속도 값을 특징으로 한다.
seismic 데이터 분석을 위해 사용된 교차플롯은 VP/VS 값 약 1.88을 기준으로 sandstone을 효과적으로 구별할 수 있음을 보여준다. VP/VS 값이 1.88보다 높으면 mudstone으로 분류되고, 낮으면 sandstone으로 간주된다.
실제 seismic angle gathers은 well w35에서 얻은 탄성 매개변수 곡선으로 합성되어, 실제 seismic 데이터와 높은 일치도를 보여주며, 전처리가 매우 정확하게 수행되었음을 확인한다.
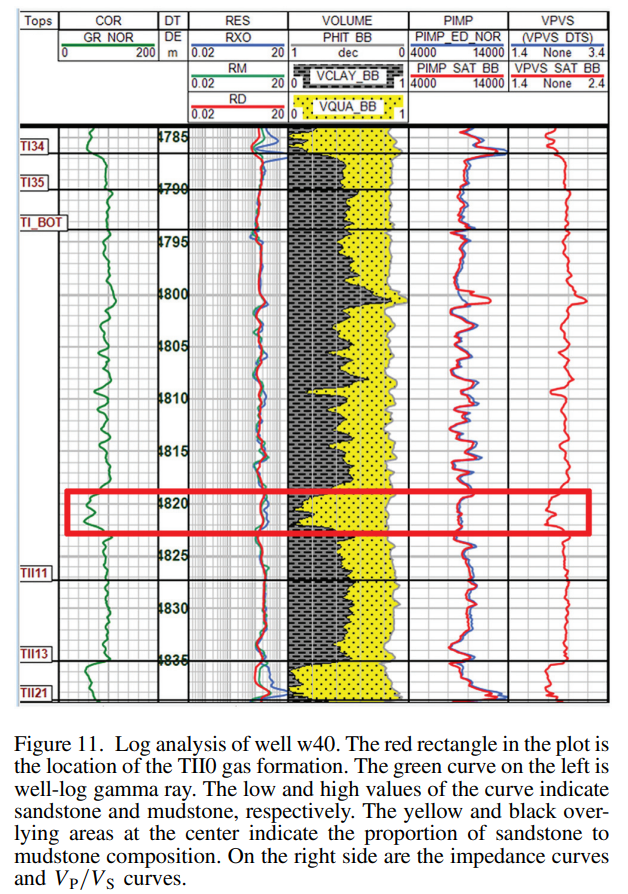
그림 설명: 그림 11. 목표 사암의 탄성파 응답과 탄성 속성 관계를 보여주는 현장 자료.
P-임피던스와 VP/VS의 교차 플롯을 사용하여 암석학을 구분하며, 이는 fig. 12에서 보여주고 있다.
그림에서 노란색으로 표시된 sandstone은 VP/VS가 대략 1.88 일 때, 효과적으로 구별할 수 있고, 낮은 값은 sandstone으로 간주할 수 있다. 대상 sandstone의 값은 대략 1.7~1.88이다.
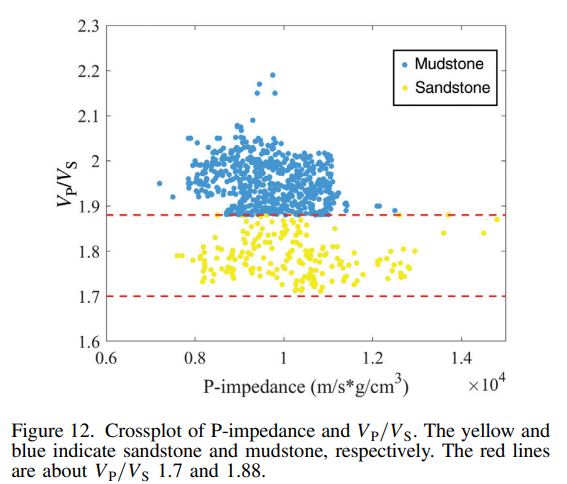
그림 설명: 그림 12. P-임피던스와 Vp/Vs 교차도. 이 자료에서 약 1.88의 Vp/Vs 기준으로 사암과 이암을 구분한다.
fig. 13은 well w35의 세 가지 탄성 매개변수 곡선과 seismic gather를 보여준다.
탄성 매개변수 곡선으로 합성된 seismic angle gather는 실제 seismic angle gather와 매우 일치한다.
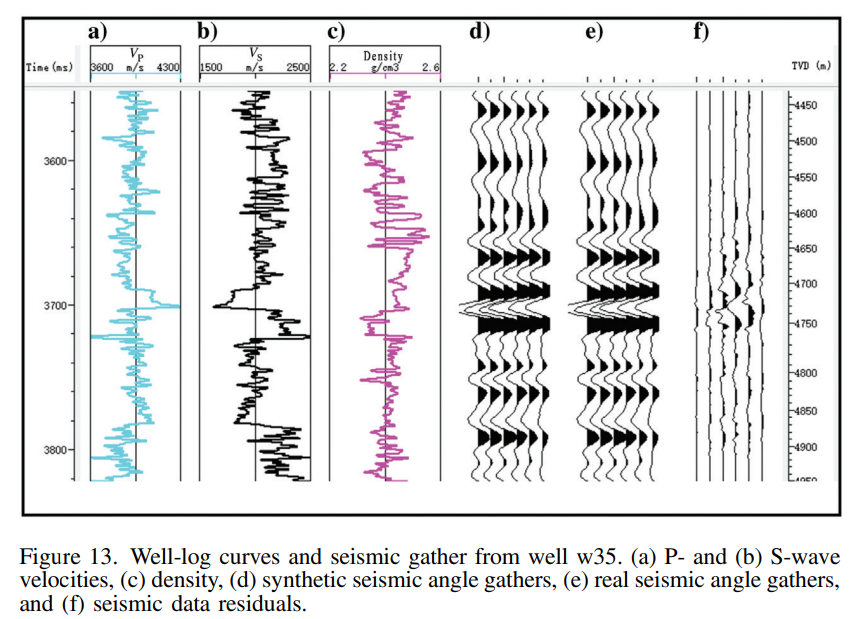
그림 설명: 그림 13. w35 우물의 탄성 매개변수 곡선과 합성·실제 입사각 모음 자료 비교.
Inversion results analysis
목표 저류층의 분포를 정성적으로 분석하기 위해 seismic 암상 분류 결과를 이용한다. 원문의 14는 분석 시간(초)이 아니라 그림 번호(fig. 14)를 가리킨다.
fig. 14는 최종 암상 분류 결과를 보여준다.
그림에서 노란색과 파란색은 각각 sandstone과 mudstone의 퇴적 분포를 나타낸다.
합성 데이터 테스트에서 불균형 훈련 well 문제를 완화하는 방법을 보여준다.
암상 제어 하에, 다양한 특징을 가진 사전 원자들이 well log에서 추출된다.
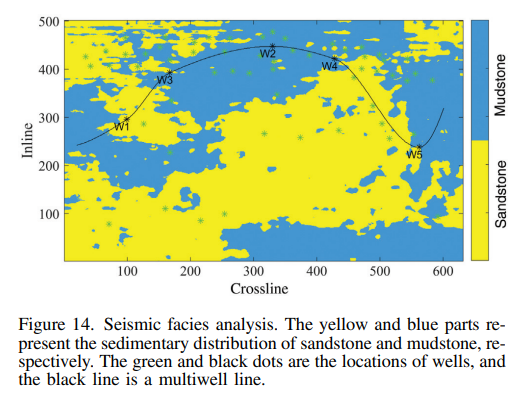
그림 설명: 그림 14. 현장 자료의 암상 분류 결과와 우물·프로파일 위치.
fig. 15에서 보듯, 다양한 암상의 well log에서 해당 특징을 가진 원자들이 추출된다.
빨간색 직사각형으로 표시한 부분은 목표 저류층의 위치를 나타낸다. 목표 저류층 위치에서, sandstone 암상에서 추출된 원자들은 대부분 높은 속도와 고밀도를 가지고 있는 반면에, mudstone 암상에서 추출된 원자들은 일반적으로 낮은 속도와 저밀도를 가진다.
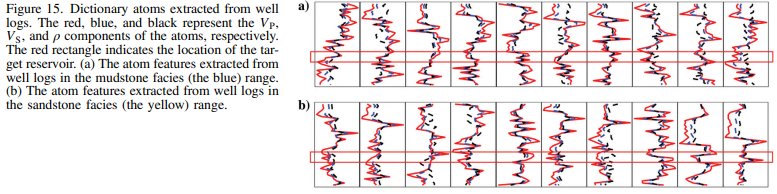
그림 설명: 그림 15. 사암과 이암의 검층 자료에서 추출한 사전 원자. 표시 영역은 목표 저류층이다.
fig. 16은 seismic data의 multiwell line 프로파일을 보여준다.
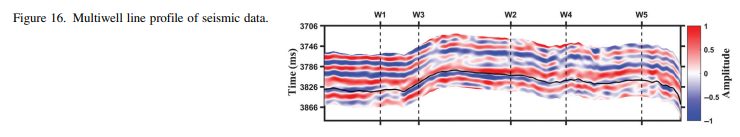
그림 설명: 그림 16. 여러 우물을 지나는 탄성파 프로파일.
fig. 17은 Vp/Vs에 대한 multiwell line 프로파일을 보여준다.
multiwell line의 위치는 fig. 14에 표시되어 있다.
그림에서 검은 직사각형의 세부사항에서 LFC가 주변의 큰 sandstone 세트와 목표 sandstone을 구분할 수 없음을 확인할 수 있으며, CSR의 sandstone 분포 특성이 암상의 것과 확연히 다르다. GMMI의 sandstone 분포 특성은 암상의 특성과 상대적으로 일치하며, FCSR의 sandstone 특성은 암상의 것과 더 일치한다.
결과적으로 FCSR 방법은 지질학적 특성과 가장 일치하는 결과를 제공하며, 다양한 층의 두께와 암상을 정확하게 식별할 수 있는 능력을 입증했다.
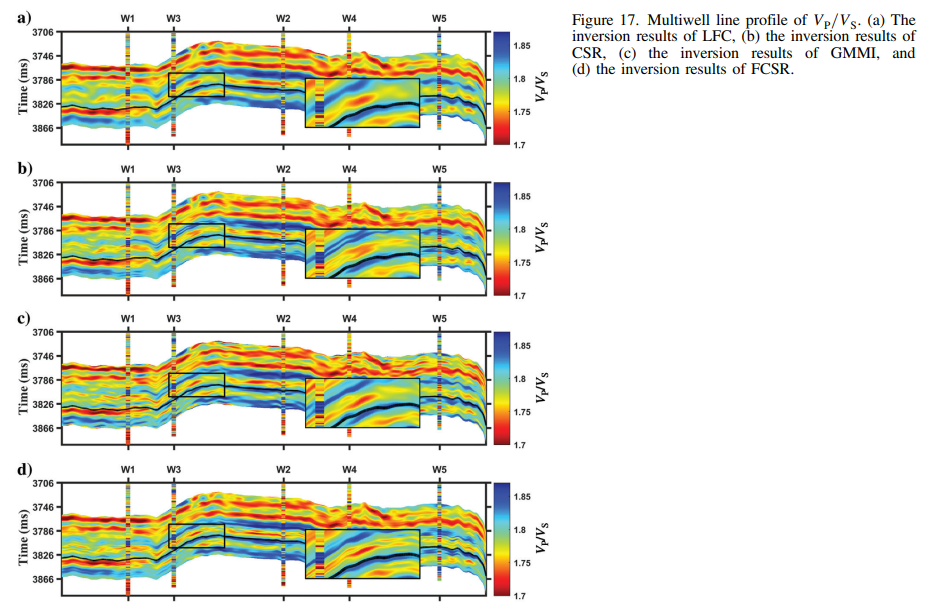
그림 설명: 그림 17. 여러 우물을 지나는 Vp/Vs 역산 프로파일의 방법별 비교.
fig. 18은 대상 저류층의 sandstone 분포를 조사한 것이다.
대상 층의 sandstone에 대한 Vp/Vs에 따라 통계적으로 얻은 sandstone의 두께 분포도를 보여준다.
전반적인 분포 추세에서, LFC inversion(fig. 18a)과 CSR inversion(fig. 18b)은 얇은 sandstone의 두께를 정확히 식별할 수 없다.
GMMI(fig. 18c)와 FCSR(fig. 18d)의 결과에서는 얇은 sandstone의 분포가 실제 채널 분포와 기본적으로 일치한다. 이는 주로 주 채널의 양쪽에 있는 지류채널과 만에서 발달하지만, 주 채널에서는 발달하지 않는다. 주 채널의 물 흐름이 더 크고 빠르며, 퇴적물이 쉽게 쌓이지 않기 때문이다. 그러나 수력학적으로 약한 지류채널에서는 퇴적물이 쉽게 쌓인다.
GMMI 방법은 다양한 암상의 탄성 매개변수의 통계적 특성을 고려하기 때문에, inversion 결과에는 암상 관련 정보가 포함되어 있으며, GMMI에서 얇은 sandstone의 분포는 LFC 및 CSR 보다 우수하다.
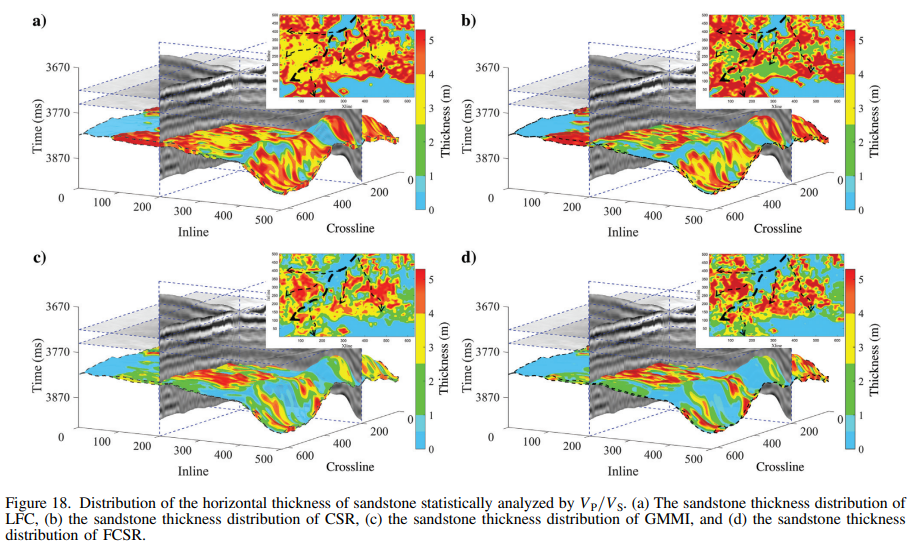
그림 설명: 그림 18. Vp/Vs를 바탕으로 추정한 목표 사암 두께의 공간 분포 비교.
fig. 19는 GMMI와 FCSR을 사용한 단일 채널 inversion 결과를 보여준다.
fig. 19a에 나타난 w26 well은 inversion 과정 전체에 참여한 반면, fig. 19b에 나타난 w24 well은 어떤 inversion 과정에도 참여하지 않은 '블라인드 well'이다. w26 well에 대한 GMMI와 FCSR 결과는 실제 well log 곡선과 상당히 일치하지만, 검은 화살표가 가리키는 FCSR의 구조적 특징이 더 우수하다. 또한, 이 FCSR의 이점은 fig. 19b의 검은색 화살표가 가리키는 블라인드 well w24에서 더욱 명확히 나타난다.
그러나, 전반적으로, w24 well에서 inversion 결과와 실제 well log 곡선과의 일치율은 w26 well 만큼 좋지 않다.
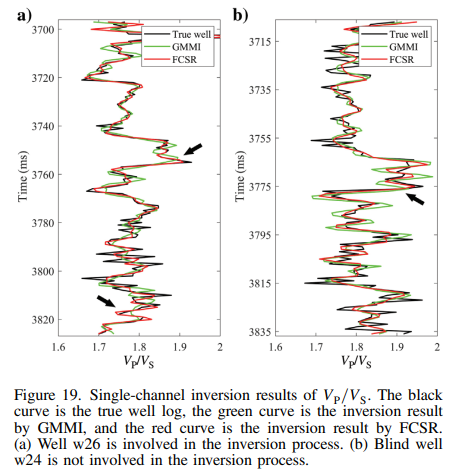
그림 설명: 그림 19. 참여 우물 w26과 블라인드 우물 w24에서 GMMI·FCSR 결과를 실제 검층 곡선과 비교한다.
Table 2는 두께 분포도와 well log 간의 적합도를 계산한 것이다.
well data와 FCSR의 적합도는 84.8%이며, 평균 오차는 1.5m이다.

그림 설명: 표 2. 우물 자료와 추정 두께의 일치도 및 오차. 본문의 FCSR 적합도는 84.8%, 평균 오차는 1.5m로 제시된다.
Discussion
제안된 방법에서는 seismic 딥 속성을 기반으로 한 암상 분석 기술을 사용하여 정확한 암상 분포를 구성한다. 그런 다음 CSR 알고리즘을 사용하여 well log에서 다양한 암상의 기본 퇴적 구조적 특성을 추출하여, inversion 도중 다른 암상의 저류층 매개변수를 실시간으로 희소하게 표현할 수 있다.
이 방법은 well log에서 특성을 추출해야 하며, 따라서 well log에 대한 두 가지 요구사항이 있다.
- 각 암상에서 구조적 특성을 학습하기에 충분한 well log가 있어야 한다.
- 각 암상에서 well log 샘플이 있어야 한다.
well log의 총개수가 적은 경우, 각 암상에서 분포된 샘플 수는 더 적을 수밖에 없다.
제안된 방법은 암상의 퇴적 패턴을 완전히 학습할 수 없으며, 좋은 inversion 결과를 얻을 수 없다.
WSM(fig. 2)을 사용하여 잘못된 암상이 inversion에 미치는 영향을 테스트하였으며, 이는 fig. 20에 나타냈다.
fig. 20a~20c는 다양한 임의 오류를 가진 암상을 보여준다. 잘못된 암상은 제안된 방법의 효과를 테스트하기 위해 사용된다.
그림 20은 WSM 합성모델에 임의 암상 오류를 넣은 실험입니다. 이 조건에서 오류율이 5%에서 10%로 늘어날 때 역산 오차가 크게 증가했습니다. 이를 모든 저류층에서 ‘5%까지 안전’이라는 보편적인 허용 기준으로 사용할 수는 없습니다.
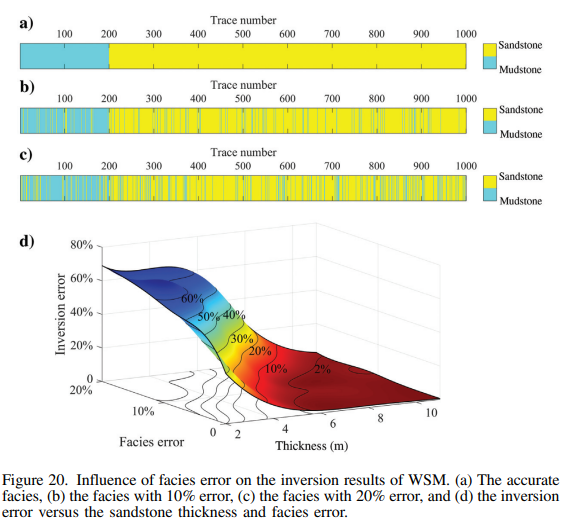
그림 설명: 그림 20. WSM의 암상 분류에 임의 오류를 넣은 민감도 실험. 오류율 5%에서 10%로 늘릴 때 역산 오차가 크게 증가한다.
fig. 21은 데이터의 수평 연속성이 떨어질 때 inversion에 미치는 영향을 테스트한 것이다.
깊은 지층과 나쁜 수평 연속성을 가진 프로파일을 선택한다.
프로파일 오른쪽에는 강한 단층과 굴곡이 있고, 왼쪽에도 수평 연속성이 좋지 않다.
지구 통계적 보간을 사용하여 샘플을 증가시킬 때, 수평적 변화가 강한 지층에서 새롭게 생성된 샘플의 구조적 특성이 기존 샘플과 부분적으로 일치한다.
지층 구조의 변화에 완전히 부합하는 새로운 샘플을 구축하는 것은 불가능하다.
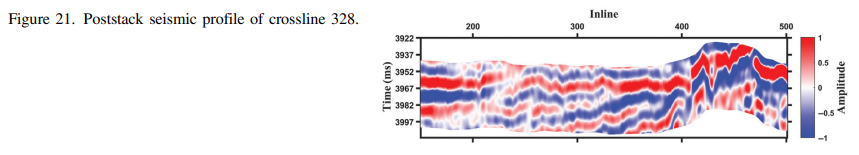
그림 설명: 그림 21. 수평 연속성이 나쁘고 구조 변화가 강한 자료를 이용한 시험 프로파일.
fig. 22는 CSR과 제안된 FCSR 방법의 prestack seismic inversion 결과를 보여준다.
그림 21~22는 수평 연속성이 나쁜 자료에서의 결과를 보여줍니다. 일부 구조 차이는 있지만, 이런 조건에서는 FCSR의 이점이 뚜렷하지 않다는 한계도 함께 읽어야 합니다. 연속성이 좋은 예제의 우위를 모든 지질 구조에 그대로 확장하지 않습니다.
그림 22의 일부 위치에서는 FCSR이 지층의 불연속성을 더 잘 표현하지만, 수평 연속성이 나쁜 조건에서 전반적인 이점이 뚜렷하다고 일반화하지 않습니다. 국소적으로 좋아 보이는 구조와 전체 자료의 정량적인 개선을 구분해야 합니다.
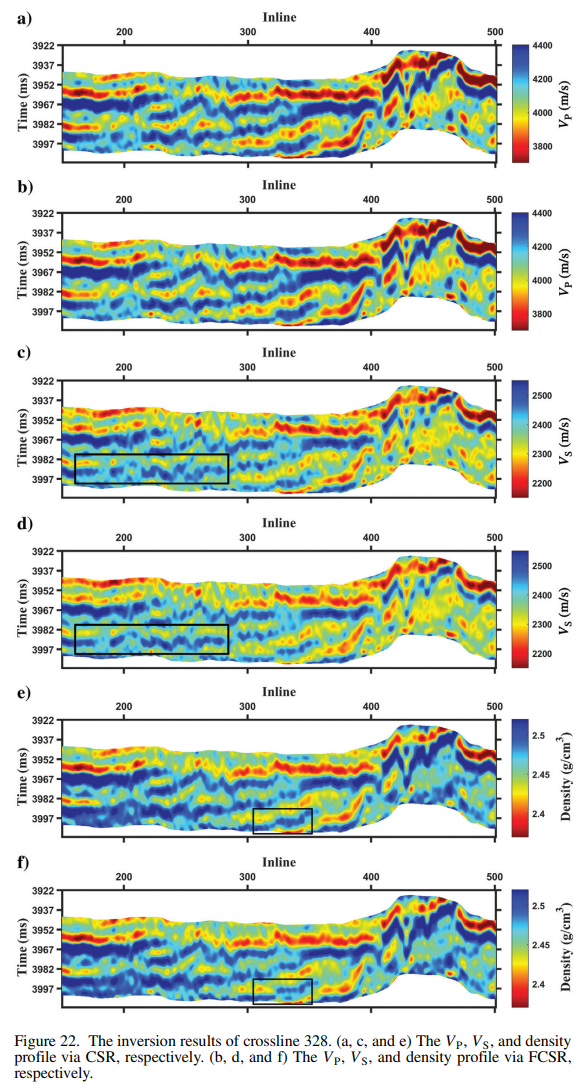
그림 설명: 그림 22. 수평 연속성이 나쁜 자료의 CSR·FCSR 탄성 매개변수 비교. 일부 세부 차이와 전체적인 개선 한계를 함께 읽어야 한다.
Conclusion
본 논문에서는 암상 제어 퇴적 구조적 특성에 의해 제한된 prestack seismic inversion 방법을 제안한다.
제안된 방법은 각 암상의 특성을 포착하는 데 중점을 둔다.
제안된 방법론을 기반으로, 몇몇 암상 사이에 존재할 수 있는 불균형한 well log의 문제를 해결하면서 정확한 암상 분포를 구성한다.
다음, 다양한 암상의 well log에서 저류층 구조적 특성을 추출한다.
마지막으로, inversion 결과는 해당 암상의 구조적 특성에 의해 희소하게 표현되고, 표현 결과를 역산의 초기값으로 사용하여 반복한다.
기존의 prestack seismic inversion과 달리, 제안된 방법은 같은 암상 내의 퇴적 구조적 특성의 균일성과 여러 암상 간의 다른 특성을 고려한다.
연구 결과, 제안된 방법은 더 얇은 저류층 inversion을 수행할 수 있으며, 얇은 층 sandstone의 분포를 더 정확하게 설명할 수 있다.
제안된 방법은 유연하며 유사한 inversion 문제에 쉽게 적용할 수 있다.
**이하 모든 내용 및 이미지는 "A prestack seismic inversion method constrained by facies-controlled sedimentary structural features" 논문을 참고하여 작성하였습니다.
원문 확인: Ting Chen 외, A prestack seismic inversion method constrained by facies-controlled sedimentary structural features, GEOPHYSICS. 논문 DOI 및 출판 정보.
해석 범위: 본문의 Vp/Vs 1.88 기준과 두께 추정 성능은 논문에서 사용한 자료와 실험 조건에 따른 결과이며, 모든 저류층에 공통으로 적용되는 기준은 아닙니다.
리뷰: 이미 시행한 검증과 추가로 확인할 조건
논문은 그림 19에서 학습·역산에 참여하지 않은 w24 블라인드 우물을 비교했고, 그림 20에서 잘못된 암상 입력도 시험했습니다. 독립 검증이나 암상 오류 실험이 없었다고 비판하는 것은 맞지 않습니다. w24의 전체 적합도는 참여 우물 w26보다 낮다는 점도 함께 봐야 합니다.
다른 저류층에 적용한다면 여러 블라인드 우물과 별도 조사 자료에서 성능을 비교하고 싶습니다. 특히 무작위 오류와 달리 암상 경계가 한 방향으로 밀리는 오류는 공간적으로 상관되어 있으므로, 같은 오류 비율이어도 영향이 다를 수 있다는 검증 가설을 세울 수 있습니다. 사전정보를 강하게 넣어 구조가 선명해진 것과 독립 관측에 더 잘 맞는 것을 구분하는 것이 적용 판단의 핵심입니다. 이는 새 실험 결과가 아니라 이 글의 추가 평가 제안입니다.

