* 해당 논문 리뷰는 글쓴이가 직접 읽고 이해한 내용을 바탕으로 작성된 것이므로, 잘못된 정보가 포함될 수 있습니다. 잘못된 정보는 댓글로 남겨주시면 반영하겠습니다 : )
- Mengyi Wu, Lihua Fu, Wenqian Fang, and Jiajia Cao
- Geophysics
- 2024
Introduction
이 논문에서는 POCS 알고리즘을 convolution layer에 적용하는 새로운 탄성파 자료 보간 네트워크인 SP-net을 제안한다. SP-net은 규칙 및 불규칙적으로 샘플링된 탄성파 자료의 보간을 효과적으로 수행하기 위해 네트워크 구조와 손실 함수를 설계한다. 구체적으로, 고정된 수의 단계로 구성되고, 각 단계는 POCS 알고리즘의 반복에 해당한다. "Conv+ReLU+Conv" layer는 POCS의 고정된 변환을 대체하며, 모든 매개변수(네트워크 기반 변환 및 임계값 매개변수 포함)는 훈련 데이터 세트를 통해 학습된다. 제안된 네트워크의 장점은 다음과 같다.
- 전통적인 sparse prior 기반 알고리즘을 deep CNN으로 전환하여 설계되었으며, 희소성 촉진 및 딥러닝 방법의 장점을 결합한다. 또한, 전통적인 POCS 방법과 일치하는 구조를 가지며, 해석 가능성과 일반화 능력을 갖춘 새로운 네트워크를 제공한다.
- 전통적인 POCS 방법과 비교했을 때, SP-net에 관련된 모든 매개변수는 큰 훈련 데이터 세트를 통해 자동 학습되며, 이는 더 적응적이고, 효율적이다. 네트워크 훈련 후, 목표 탄성파 데이터는 네트워크에 직접 입력하여 재구성될 수 있다. 규칙 및 불규칙으로 샘플링된 자료의 보간 작업을 위한 테스트를 수행하여 SP-net이 전통적인 POCS 반복 방법을 크게 능가하는 동시에 빠른 계산 속도를 유지함을 보여준다.
Method
Review of the POCS method
탄성파 데이터 보간은 다음과 같은 수학적 모델로 표현될 수 있다.
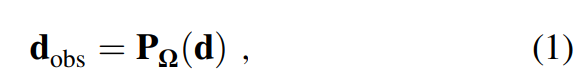
그림 설명: 식 1. 관측 자료 d_obs는 완전한 자료 d에 관측 위치 투영 P_Ω를 적용한 값이다.
- d_obs: 관측된 데이터
- d: 완전한 데이터
- Ω: 관측된 항목에 해당하는 인덱스 부분집합
- PΩ(·): 투영 연산자
투영 연산자 PΩ(·)는 다음과 같이 정의된다.
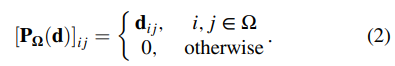
그림 설명: 식 2. P_Ω는 관측 위치 Ω의 원소를 보존하고 나머지 원소를 0으로 만든다.
- PΩ(d): 특정 인덱스 집합 Ω에 속하는 데이터 포인트를 유지하고, 나머지를 0으로 설정하는 투영 연산자
이에 따라 POCS의 목적함수는 다음과 같이 나타낼 수 있다.
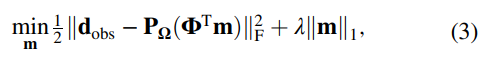
그림 설명: 식 3. 관측 잔차의 프로베니우스 노름 제곱의 절반에 희소 계수 m의 L1 노름과 가중치 λ를 곱한 항을 더해 최소화한다.
- m=Φd: 희소 계수
- Φ: 푸리에 변환이나 커블렛 변환과 같은 사전에 선택된 희소 변환
-
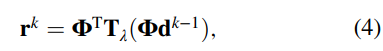
그림 설명: 식 4. 이전 복원값을 Φ로 변환하고 임계 연산 T_λ를 적용한 다음 Φ의 전치로 되돌려 r의 k번째 값을 구한다.
- k: 반복횟수
- Tλ(·): 임계 연산자
임계 연산자의 경우, 소프트 임계 연산자를 사용하며, 다음과 같이 나타난다.

그림 설명: 식 5. 소프트 임계 연산: 절댓값이 λ 이상이면 x에서 λ 곱하기 sign(x)를 빼고, 그보다 작으면 0을 반환한다.
- 특정 임계값 λ에 따라 값을 조정
2. Data projection
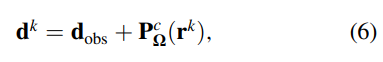
그림 설명: 식 6. d의 k번째 복원값은 관측 자료에 r의 k번째 값 중 미관측 위치의 값만 더한다.
- d^0 = d_obs
PcΩ는 다음과 같이 정의된다.
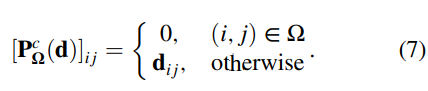
그림 설명: 식 7. 보완 투영 P_Ω^c는 관측 위치에서 0을, 미관측 위치에서 입력값을 반환한다.
sparse prior 기반 방법은 다음 알고리즘 1과 같이 진행된다.

그림 설명: 알고리즘 1. 관측 자료로 초기화한 뒤 희소 임계 연산과 관측 위치 재삽입을 반복하는 POCS 보간 절차.
재구성된 데이터 d_recover는 식(4), (6)을 반복적으로 해결함으로써 얻을 수 있다. 이때, 하이퍼파라미터 λ, 희소 변환 Φ는 경험적으로 선택된다.
Sparse prior-net
이 논문에서는 기존의 POCS 방법의 반복 과정을 딥러닝 네트워크로 펼쳐 구현한 새로운 희소 선행 기반 보간 네트워크인 SP-net을 제안한다.
SP-net은 고정된 수의 단계로 구성되어 있으며, 각 단계는 전통적인 POCS의 한 번의 반복에 엄격하게 해당한다. 네트워크는 두 개의 모듈로 구성되어 있으며, 이는 식 (4)와 (6)의 두 절차에 해당한다. SP-net의 두 모듈은 sparse prior layer (rk)과 재구성 layer (dk)으로 명명된다.
SP-net은 POCS 프레임워크와 동일한 알고리즘 구조를 유지하지만, 하이퍼파라미터 λ와 희소 변환 Φ이 학습 가능하다.
sparse prior layer (rk): 이 층은 탄성파 데이터의 sparse prior을 탐색하는 데 사용되며, 식 (4)에 해당한다. SP-net은 식 (4)에서 경험적으로 얻은 희소 변환 Φ 대신, 합성곱 연산과 비선형 활성화 함수를 사용한다. 이는 다음과 같이 행렬 형태로 표현된다.
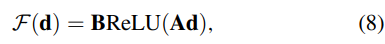
그림 설명: 식 8. 학습 변환 F(d)는 첫 합성곱 A, ReLU 활성화, 두 번째 합성곱 B를 차례로 적용한다.
- A, B: 이전 조합의 두 합성곱 연산자
- ReLU: 입력이 양수인 경우 입력을 직접 출력하고, 그렇지 않은 경우 0을 출력하는 조각별 선형 함수
희소 변환과 역방향 변환에 대응하도록 F와 F̃를 학습합니다. 손실에는 F̃(F(d))가 d에 가까워지도록 하는 변환 일관성 항을 넣습니다. 이는 F를 적용한 다음 F̃를 적용하는 순서이며, 모든 입력에서 정확한 역함수 관계를 강제하는 조건은 아닙니다. 각 단계의 변환과 임계값은 학습 가능한 매개변수입니다.
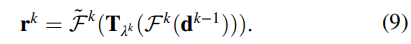
그림 설명: 식 9. 단계 k에서 F로 변환하고 학습 임계값으로 희소화한 뒤 역방향 변환 F̃를 적용해 r을 만든다.
재구성 layer (dk): 이 층은 식 (6)과 연결되어 있으며, 탄성파 데이터의 재구성을 담당한다. 초기 데이터 d_0는 관측 데이터 d_obs로 설정된다. sparse prior layer (rk)에서 계산된 출력값을 사용하여, 현재 layer의 재구성 결과 dk를 얻는다. 출력 dk는 다음 공식을 통해 업데이트된다.
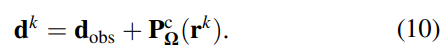
그림 설명: 식 10. 관측 자료는 보존하고 미관측 위치에만 희소화 결과를 삽입하는 SP-net 재구성 층.
- PcΩ(rk): sparse prior layer의 결과 rk에 적용되는 보완적 투영 연산자이며, 이 연산자는 rk에서 관측되지 않은 인덱스 집합 Ω의 여집합(Ωᶜ)에 해당하는 값들만을 유지하고, 그 외의 값을 0으로 설정
이 재구성층은 관측된 데이터와 sparse prior layer의 출력 rk를 결합하여 최종적인 탄성파 데이터의 재구성을 수행함으로써, 불완전하게 샘플링된 데이터를 보다 완전한 형태로 복원하는 역할을 한다. 이 과정은 네트워크가 효과적으로 데이터의 누락된 부분을 추정하고 복원할 수 있도록 지원한다.
fig. 1은 이 논문에서 제안한 SP-net의 프레임워크이다. SP-net의 전체 아키텍처를 보여주며, 각각의 구성 요소가 어떻게 연결되어 있는지 나타냈다. 이는 각 단계에서의 F(·), F~(·) 레이어와 해당 연결들을 시각적으로 보여준다.
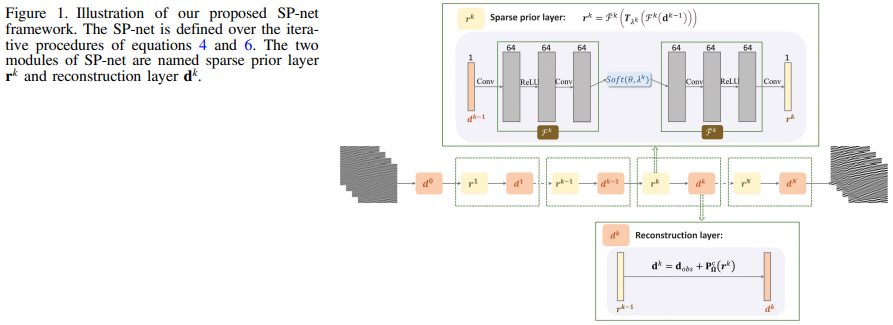
그림 설명: 그림 1. POCS 반복을 유한한 단계로 펼친 SP-net 구조. 각 단계에서 학습 변환·희소화·역방향 변환과 자료 투영을 수행한다.
Loss function design
SP-net은 관측 자료 d_obs를 입력받아 N단계의 복원값 d_N을 출력합니다. 손실은 최종 복원 오차 L1과 변환 일관성 오차 L2의 가중합 L_total=L1+γL2입니다. 여기서 L1·L2는 두 손실 항의 이름이며 L1·L2 노름을 각각 사용한다는 뜻이 아닙니다. 식 (12)의 L2는 F̃(F(d))가 d에 가까워지도록 학습하는 제곱 오차입니다. 따라서 변환의 순서는 F 다음 F̃이며, 모든 입력에서 정확히 역함수가 된다는 엄격한 보장은 아닙니다.
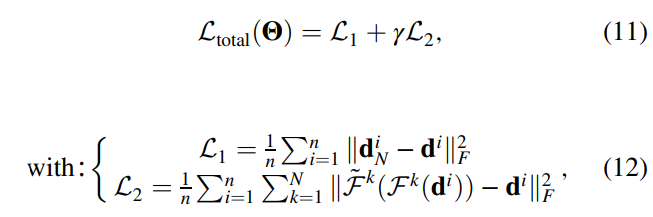
그림 설명: 식 11–12. 전체 손실은 L1+γL2. L1은 최종 복원값과 기준 자료의 제곱 오차, L2는 단계별 F̃(F(d))와 d의 제곱 오차이다. 두 항의 명칭 L1·L2는 노름 차수를 뜻하지 않는다.
재구성 단계의 수
- n: 훈련 데이터 세트의 수
- γ: SP-net의 정규화 매개변수
이 손실함수의 구성은 다음과 같은 목적을 가진다.
- L1 손실: 이는 재구성된 데이터 d_N과 실제 데이터 d_i 사이의 차이를 최소화하는 데 초점을 맞춘다. 이는 네트워크가 관측된 데이터를 기반으로 정확한 재구성을 수행하도록 돕는다.
- L2 손실: 이는 각 F_k와 그 역변환 F'_k 간의 상호작용을 통해 재구성된 데이터가 원본 데이터에 가깝도록 유지하는 것을 목표로 한다. 이 손실은 네트워크가 각 단계에서 데이터의 일관성을 유지하도록 보장하는 데 도움을 준다.
Experiments
훈련된 SP-net은 규칙적 및 불규칙적으로 샘플링된 탄성파 데이터의 보간에 사용된다. 또한, 이 방법은 전통적인 방법들(커블릿 변환, 특이 스펙트럼 분석[SSA], f-x 예측 필터링 방법)과 딥러닝 기반 방법들(U-net 및 CNN-POCS)과 비교된다.
재구성 품질 평가를 위해 신호 대 잡음비(S/N)가 사용된다.
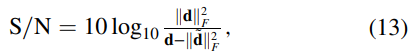
식 (13)의 계산을 텍스트로 쓰면 S/N = 10 log10(‖d‖F² / ‖d − d̃‖F²) dB입니다. 분모는 오차 d − d̃ 전체의 프로베니우스 노름 제곱입니다. d − ‖d̃‖F²처럼 자료에서 스칼라 에너지를 빼는 식으로 읽으면 안 됩니다. 오차가 0이면 이 정의의 S/N은 무한대로 발산합니다.
그림 설명: 식 13. S/N은 기준 자료 에너지를 복원 오차 에너지로 나눈 비의 상용로그에 10을 곱한 dB 값이다.
- d: 완전한 데이터
- d~: 재구성된 데이터
이 식은 완전한 데이터와 재구성된 데이터 간의 차이를 기반으로 한 신호 대 잡음비를 계산하여, 재구성된 데이터의 품질을 수치적으로 평가하는 데 사용된다. 이 수치가 높을수록 재구성 품질이 더 좋다는 것을 의미한다.
Data preparation
데이터 세트는 각 샷 당 800개의 트레이스와 각 트레이스당 1,151개의 시간 샘플을 포함하고 있으며, 시간 및 공간 샘플링 간격은 각각 8 ms와 12.5m이다. 첫 400개 샷에서 무작위로 24,000개의 패치를 훈련 세트로, 401에서 500 샷에서 6,000개의 패치를 검증 세트로 잘라낸다. 각 패치의 크기는 128 ×128이다.
fig. 2는 훈련 데이터 세트에서의 일부 탄성파 데이터를 보여준다.

그림 설명: 그림 2. 훈련 자료에서 잘라낸 여러 탄성파 패치의 예.
각 패치는 최소-최대 방법을 사용하여 0과 1 사이로 정규화된다. 랜덤 하게 손실된 데이터의 경우를 모방하기 위해, 각 완전한 패치에서 총 트레이스의 50%를 랜덤/규칙적으로 제거하여 네트워크 입력으로 사용한다. 동일한 훈련 데이터 세트는 세 가지 딥러닝 기반 방법(U-net, CNN-POCS, 제안된 네트워크)에 사용된다.
Training stage and experimental parameters setting
네트워크 훈련에는 Adam 최적화 방법을 사용하며, 초기 학습률은 0.0001로 설정되고, 10 epoch마다 0.9배로 감소한다. 배치 크기는 16으로 설정된다. 모델 성능은 각 epoch 후 검증 세트의 평균 S/N 값으로 평가된다.
훈련 epoch의 수는 두 매개변수를 선택하기 위해 100으로 설정된다. 하이퍼파라미터 γ에 대해서는 검증 데이터 세트에서의 S/N 값에 따라 최적의 매개변수 γ를 결정할 수 있으며, γ = 0, 0.01, 0.1, 1을 테스트한 결과, γ = 0.1이 가장 높은 S/N 값을 달성한다.
재구성 단계 N과 훈련 epoch 수에 대한 매개변수 설정도 성능과 수렴을 기반으로 논의된다. 다른 재구성 단계 N 수에 따른 검증 세트의 S/N 곡선을 보여주는 fig. 3에서는 N의 수가 증가함에 따라 S/N 값이 증가하지만, N ≥ 9일 때 곡선은 실질적으로 평탄해진다. 네트워크 복잡성과 훈련 성능 사이의 좋은 균형을 달성하기 위해 N을 9로 선택한다. SP-net의 임계값 λ은 학습 가능한 매개변수이며, 해당 연구에서는 처음에 0.01로 설정됩니다. fig. 4는 다른 단계 N에서의 λ 임계값 추세를 보여준다.
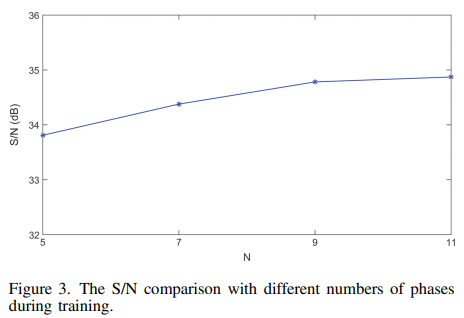
그림 설명: 그림 3. 재구성 단계 수 N에 따른 검증 S/N. 단계 수가 증가하면 성능이 높아지지만 9단계 부근부터 증가폭이 작아진다.
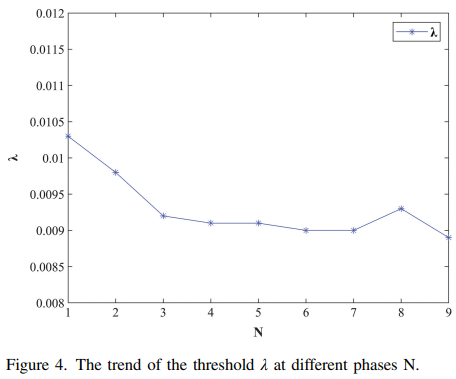
그림 설명: 그림 4. 각 재구성 단계에서 학습된 임계값 λ의 변화.
200 epoch에서의 검증 세트 손실 곡선은 fig. 5a에 나타나며, epoch 수가 증가함에 따라 손실은 점차 감소하고, 80 epoch 이후에는 수렴하는 경향을 보인다. 네트워크의 훈련 과정에서는 5 epoch 마다 검증 세트를 사용하여 현재 네트워크를 검증한다. fig. 5b는 재구성 단계 N이 9일 때, 다른 훈련 에폭에서 검증 세트의 평균 S/N 곡선을 보여준다.
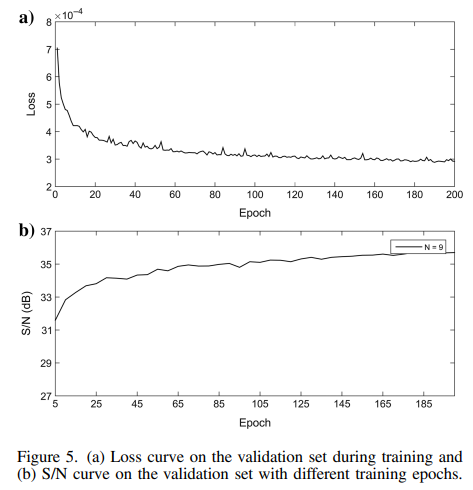
그림 설명: 그림 5. epoch에 따른 검증 손실과 S/N 곡선. 손실은 감소하고 S/N은 증가한 뒤 변화폭이 줄어든다.
Interpolation of irregularly missing traces
fig. 6a는 트레이스당 256개의 시간 샘플을 포함하는 256개의 트레이스와 세 개의 곡선 이벤트를 보여준다. 시간 및 공간 샘플링 간격은 각각 4 ms와 10 m이다. fig. 6b는 50%의 트레이스가 랜덤으로 손실된 손상된 데이터를 나타낸다.
각 테스트에 대해 최적의 결과를 얻기 위해 매개변수를 조정한다. 커블릿 방법에 대해서는 최대 임계값, 최소 임계값 및 반복 횟수를 각각 0.3, 0.02 및 40으로 설정한다. SSA 방법에 대해선 창 크기, 순위 및 처리 주파수 범위를 각각 20, 1, 0–120Hz로 설정한다.
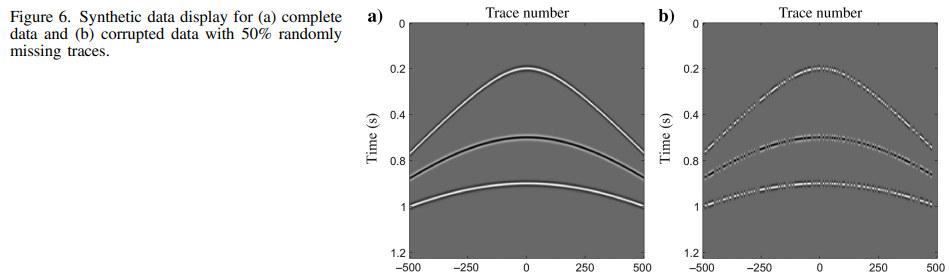
그림 설명: 그림 6. 합성 탄성파의 완전 자료와 무작위 트레이스 누락 자료를 비교하는 실험 입력.
재구성 결과는 fig. 7a–7d에서 보여지며, 커블릿 방법(S/N = 22.11 dB), SSA 방법(S/N = 20.97 dB), U-net 방법(S/N = 22.52 dB) 및 제안된 SP-net 방법(S/N = 25.97 dB)을 사용한다. 각 재구성 결과와 원본 데이터 사이의 잔차는 fig. 7e–7h에서 보여진다. SP-net은 다른 세 가지 방법보다 더 작은 잔차로 트레이스를 복구하며 가장 높은 S/N을 가진다.
더 복잡한 지질 구조를 가진 현장 데이터를 사용하여 SP-net의 재구성 성능을 조사한다. prestack 2D 현장 라인 조사 데이터는 Mobil AVO Viking Graben 데이터이다. 원본 데이터 세트는 1,001개의 샷 게더를 포함하며, 각 게더는 1,000개의 시간 샘플 × 120개의 트레이스 크기를 가지며, 시간 및 공간 샘플링 간격은 각각 4 ms와 25m이다. 커블릿 방법에 대해 최대 임계값, 최소 임계값 및 반복 횟수를 각각 500, 10, 40으로 설정한다. SSA 방법에 대해 창 크기, 순위 및 처리 주파수 범위를 각각 40, 2, 0–50Hz로 설정한다. 각 방법의 재구성 결과로 얻은 common shot gather (CSG)의 평균 회복된 S/N은 각각 8.32, 8.44, 9.53, 10.98 dB이다. S/N 값 비교는 제안된 방법이 재구성 속도를 유지하면서 더 나은 성능을 가짐을 보여준다.
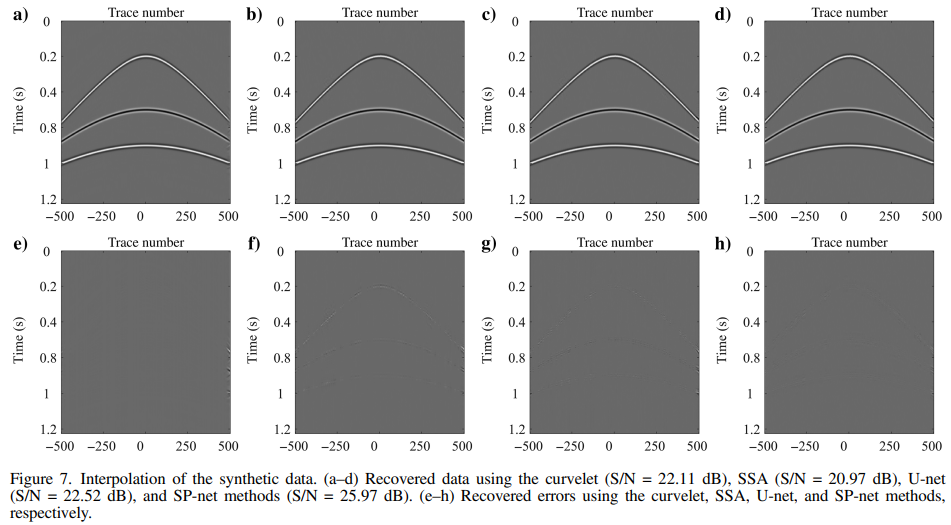
그림 설명: 그림 7. 합성 자료의 커블릿·SSA·U-Net·SP-net 복원과 잔차 비교. 표시된 S/N은 각각 22.11, 20.97, 22.52, 25.97 dB이다.
그림 8a는 현장 자료의 완전한 공통 송신점 자료를, 그림 8b는 트레이스 50%가 무작위로 누락된 자료를 보여줍니다. 가로축은 offset이고 세로축은 시간입니다. 이 그림을 3D 자료의 195번째 크로스라인 슬라이스로 설명하지 않습니다.
fig. 9는 각 CSG의 회복된 S/N을 보여주는 박스플롯입니다.
fig. 10a–10d는 커블릿, SSA, U-net 및 SP-net 방법의 재구성 결과를 보여준다. 각 그림의 왼쪽 하단에는 확대된 버전(0.6–1.35 s 및 -1.350–0 km)이 표시된다. 각각의 S/N은 9.77, 7.99, 10.30, 11.19 dB이다. SP-net의 재구성 결과는 가장 높은 S/N을 가지며 공간 차원에서 더 연속적인 이벤트를 보여준다.
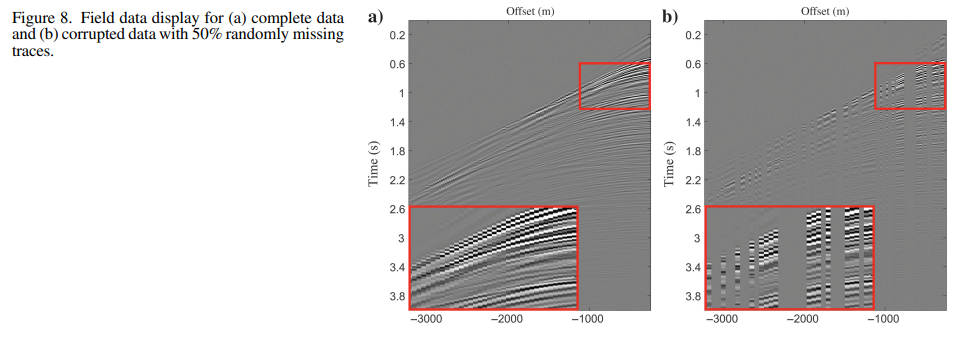
그림 설명: 그림 8. 현장 자료의 완전 자료와 트레이스 50%가 무작위로 누락된 자료. 가로축은 offset, 세로축은 시간이다.
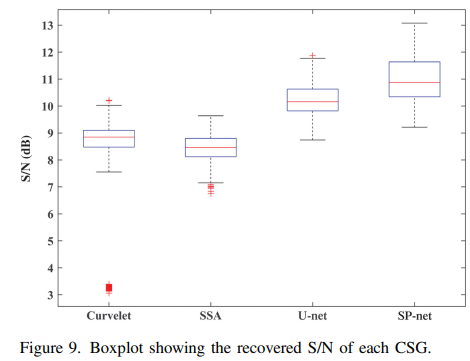
그림 설명: 그림 9. 각 공통 송신점 집합에서 계산한 네 방법의 복원 S/N 분포를 상자 그림으로 비교한다.
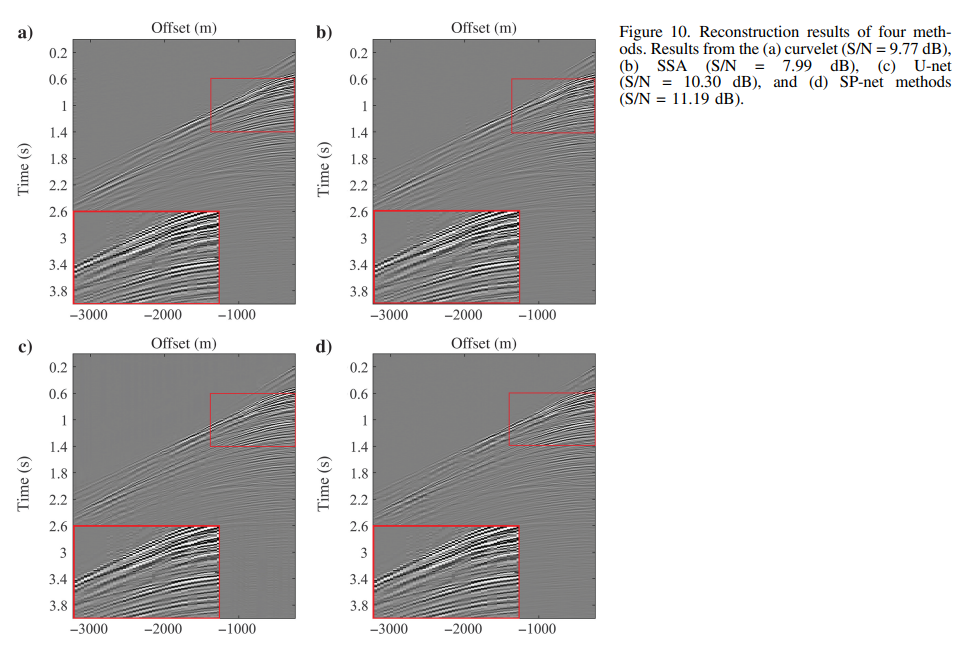
그림 설명: 그림 10. 현장 자료 복원 비교. 커블릿 9.77, SSA 7.99, U-Net 10.30, SP-net 11.19 dB로 표시돼 있다.
Table 2는 손실률이 30%에서 60%로 증가함에 따라 커블릿, SSA, U-net, SP-net 방법의 보간 결과에 대한 S/N을 제공하며, 이는 제안된 방법이 다양한 손실 트레이스 비율에 강건함을 나타낸다.
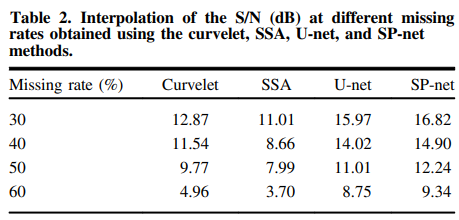
그림 설명: 표 2. 누락률 30·40·50·60%에서 네 방법의 S/N 비교. SP-net 열은 각각 16.82, 14.90, 12.24, 9.34 dB이다.
Interpolation of regularly missing traces
훈련 데이터 세트와 하이퍼파라미터 설정은 앞서 언급한 불규칙 보간 예제와 동일하다.
해양 현장 데이터를 사용하여 규칙적으로 샘플링된 데이터에 대한 SP-net 방법의 재구성 성능을 평가했다.
fig. 11a는 179개의 트레이스와 각 트레이스당 500개의 시간 샘플을 포함하는 원본 완전 데이터를 보여준다. 시간 간격은 4 ms이다. fig. 11b는 50%의 규칙적으로 손실된 트레이스를 포함한 손상된 데이터를 보여준다.
커블릿 방법에 대해 최대 임계값, 최소 임계값, 반복 횟수를 각각 1200, 25, 40으로 설정했다. f-x 방법의 경우 처리 주파수 범위와 필터 길이를 각각 0–75Hz와 5로 설정했다.
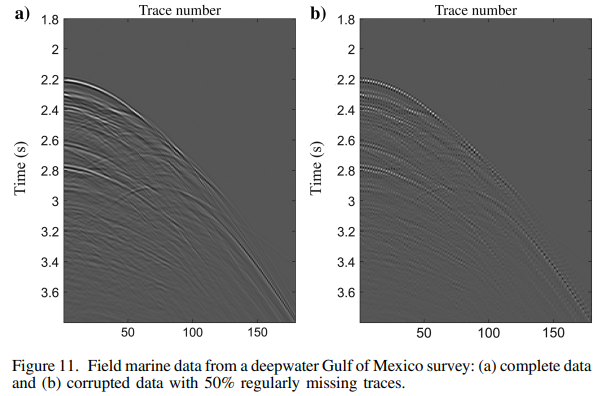
그림 설명: 그림 11. 멕시코만 심해 해양 자료의 완전 자료와 트레이스 50%가 규칙적으로 누락된 자료.
fig. 12a–12e는 커블릿, f-x, CNN-POCS, U-net, SP-net 방법을 사용한 재구성 결과를 보여주며, 각각의 S/N은 11.77, 13.08, 14.29, 16.71, 17.56 dB이다. SP-net은 다른 네 가지 방법에 비해 더 적은 오류와 더 높은 S/N을 생성한다.
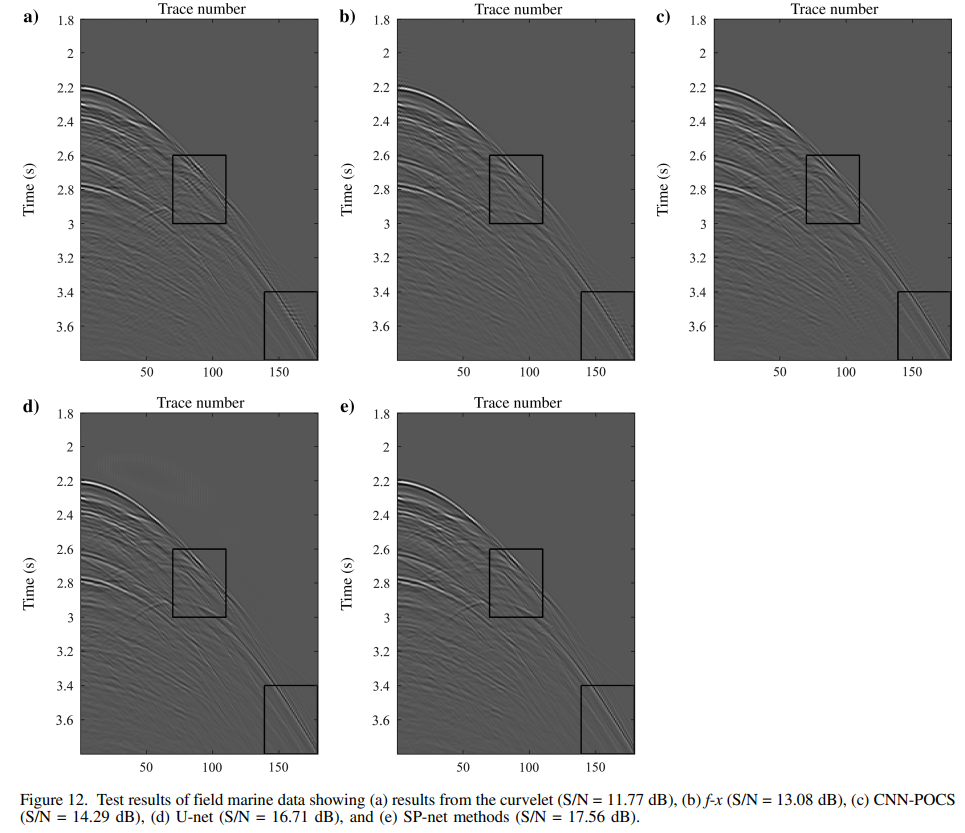
그림 설명: 그림 12. 규칙적 누락 자료의 다섯 복원 결과. 커블릿·f-x·CNN-POCS·U-Net·SP-net을 비교한다.
마지막으로, Figure 8a의 현장 데이터를 사용하여 규칙적으로 손실된 데이터에 대한 SP-net의 성능을 추가로 검증한다. fig.13은 50%가 규칙적으로 누락된 손상된 데이터를 보여준다. 커블릿 방법에 대해 최대 임계값, 최소 임계값, 반복 횟수를 각각 1200, 25, 40으로 설정했다. f-x 방법의 경우 처리 주파수 범위와 필터 길이는 각각 0–75Hz와 5이다.

그림 설명: 그림 13. 현장 자료의 트레이스를 50% 비율로 규칙적으로 누락시킨 보간 입력.
fig.14는 커블릿, f-x, CNN-POCS, U-net, SP-net 방법을 사용한 재구성 결과를 보여주며, 각각의 S/N은 10.03, 11.63, 12.44, 13.92, 15.50 dB이다. 잔차를 통해 볼 때 SP-net 방법은 가장 적은 신호 누출을 보이며, 커블릿 방법은 근접 거리에서의 트레이스 회복이 더 나쁘게 나타난다.
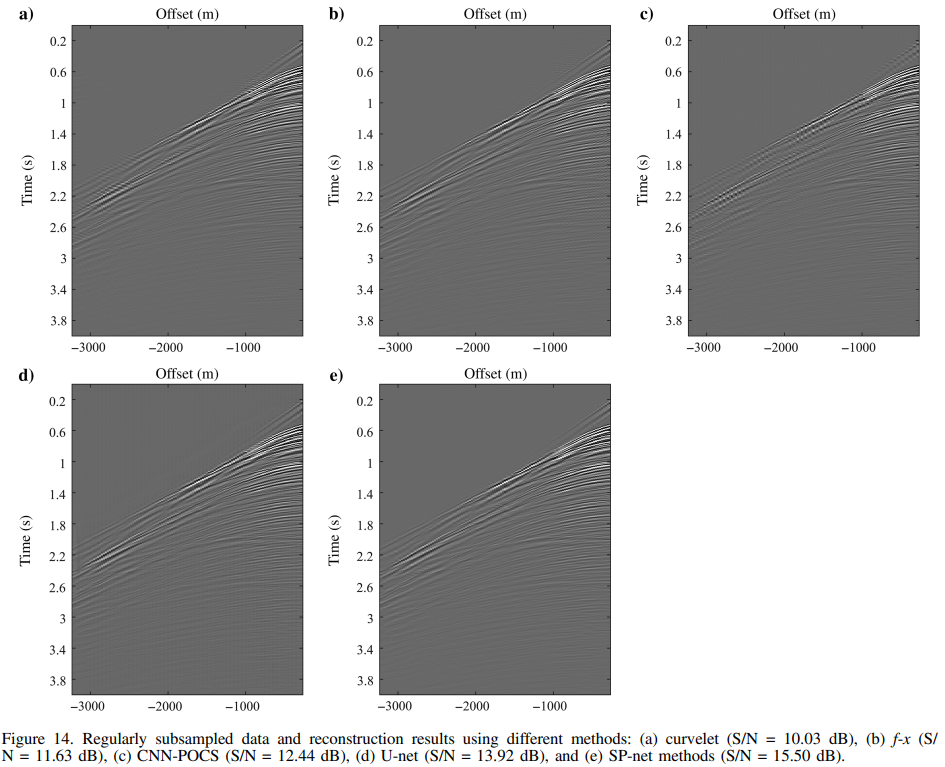
그림 설명: 그림 14. 현장 규칙적 누락 자료의 다섯 복원 결과. 표시된 S/N은 커블릿 10.03, f-x 11.63, CNN-POCS 12.44, U-Net 13.92, SP-net 15.50 dB이다.
fig. 15는 완전한 데이터, 50% 규칙적으로 손실된 데이터, 그리고 커블릿, f-x, CNN-POCS, U-net, SP-net 방법을 사용한 재구성 결과의 f-k 스펙트럼을 보여준다. fig. 15b에서 볼 수 있듯이, 규칙적으로 손실된 트레이스는 주파수-파수 공간에서 심각한 공간 에일리어싱을 초래한다. 비교한 다섯 방법은 에일리어싱 섹션의 에너지를 효과적으로 제거할 수 있으며, SP-net 방법에 의한 재구성 결과의 f-k 스펙트럼은 일반적으로 원본 데이터와 일치하는 모습을 보인다. 그에 반해 커블릿, f-x, CNN-POCS, U-net 방법에 의한 데이터 재구성은 여전히 소량의 에일리어싱 에너지를 포함하고 있다.
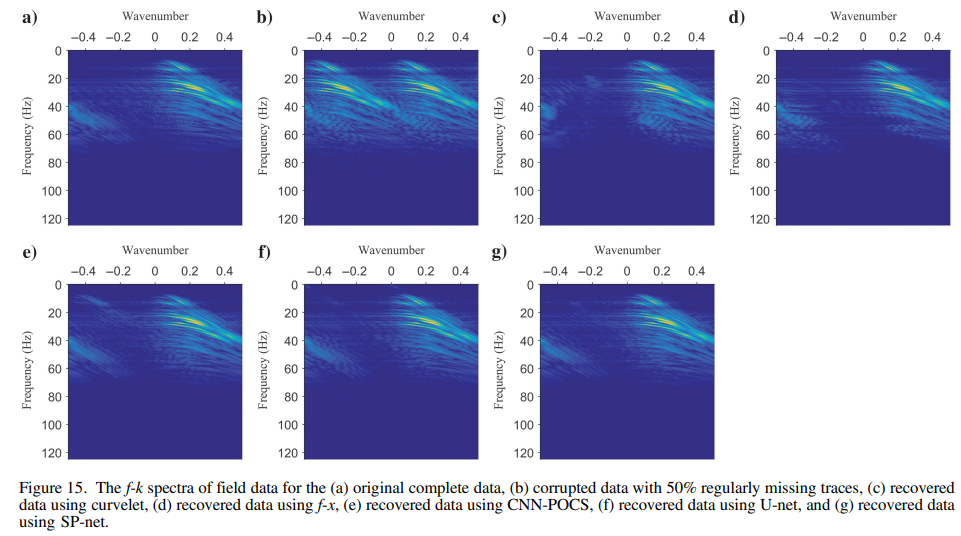
그림 설명: 그림 15. 완전 자료·규칙적 누락 자료 및 다섯 복원 방법의 주파수-파수 스펙트럼. 규칙적 누락의 공간 에일리어싱과 복원 후 차이를 비교한다.
Conclusion
POCS 방법은 변환 및 임계값 매개변수를 선택해야 한다는 필요성과 고정된 변환은 데이터 특성과 호환되지 않아 재구성 결과에 영향을 미친다는 한계가 있다. 이러한 제한을 극복하기 위해, 본 논문에서는 전통적인 POCS 방법과 딥러닝을 결합한 탄성파 데이터 보간을 위한 SP-net 네트워크를 제안한다. 이 조합은 sparse prior 기반 방법과 네트워크 기반 방법의 장점을 모두 활용한다. POCS 알고리즘의 각 반복을 신경망 층으로 대체함으로써, 모든 매개변수(변환 및 임계값 매개변수)를 신경망을 통해 학습할 수 있다. 합성 데이터 및 현장 데이터 예제는 SP-net 방법이 만족스러운 재구성 성능을 달성하면서도 빠른 계산 속도를 유지할 수 있음을 보여준다. 더 크고 다양성이 높은 훈련 데이터 세트는 제안된 방법이 더 나은 성능을 발휘하는 데 도움이 된다.
**이하 모든 내용 및 이미지는 " Sparse prior-net: A sparse prior-based deep network for seismic data interpolation" 논문을 참고하여 작성하였습니다.
서지정보와 적용 전 평가 관점
원문: Mengyi Wu, Lihua Fu, Wenqian Fang, Jiajia Cao, “Sparse prior-net: A sparse prior-based deep network for seismic data interpolation”, GEOPHYSICS, 89(1), 2024. DOI:10.1190/geo2022-0262.1.
리뷰 관점: 구조를 설명할 수 있다는 것과 일반화를 보장한다는 것은 다릅니다
POCS의 반복과 대응하는 단계를 갖추면 네트워크가 무엇을 하도록 설계되었는지 설명하기 쉽습니다. 그렇다고 학습 자료와 다른 결측 패턴에서도 정확하다는 결론이 자동으로 나오지는 않습니다. 이 방법을 적용할 때는 무작위 결측뿐 아니라 연속된 큰 결측 구간, 학습 때와 다른 누락 비율을 따로 평가해야 합니다.
또한 전체 영상 오차만 보면 관측점 보존과 결측점 복원 성능이 섞입니다. 관측점에서 입력을 얼마나 바꾸었는지와 결측점에서 참값을 얼마나 회복했는지를 나누어 보고 싶습니다. 관측점에 잡음이 있다면 입력을 정확히 보존하는 것이 항상 최선인 것도 아닙니다. 잡음 제거와 보간을 동시에 목표로 하는지부터 명확히 해야 합니다.
권호는 2024년 89(1), V37–V47이며 온라인 공개일은 2023년 10월 10일입니다. 위 평가는 원 논문에 검증이 없었다는 주장이나 새 실험 결과가 아니라, 다른 자료로 적용할 때 확인할 항목입니다. 원문의 수식·실험 설정은 논문 DOI에서 대조하세요.

